Bergbau und Staking DeFi Bitcoin

Vision Transformer (ViT) revolutioniert die Bildsegmentierung: Wie ein einfacher Encoder zur Leistungsmaschine wird

Die Vision Transformer (ViT) Architektur zeigt, dass mit ausreichend großem Modell und umfangreichem Pre-Training selbst ein einfacher Encoder zu einem leistungsstarken Bildsegmentierungsmodell wird. Dieser Beitrag beleuchtet die bahnbrechenden Erkenntnisse rund um den Encoder-only Mask Transformer (EoMT) und seine Vorteile bei Genauigkeit und Geschwindigkeit gegenüber traditionellen Methoden.

Vision Transformer (ViT) revolutioniert die Bildsegmentierung: Wie ein einfacher Encoder zur Leistungsmaschine wird

Die Entwicklung im Bereich der Bildverarbeitung hat in den letzten Jahren enorme Fortschritte gemacht. Besonders die Vision Transformer, kurz ViT, haben sich als bahnbrechend erwiesen, indem sie in zahlreichen Aufgaben der Computer Vision Spitzenleistungen erbringen. Ursprünglich für Aufgaben wie Bildklassifikation konzipiert, zeigt sich nun überraschend, dass ViTs mit der richtigen Herangehensweise auch ohne umfangreiche architektonische Modifikationen exzellente Ergebnisse in der Bildsegmentierung erzielen können. Dieser Paradigmenwechsel wird durch die jüngste Arbeit „Your ViT is Secretly an Image Segmentation Model“ eindrucksvoll gestützt, die aufzeigt, wie ein einfacher ViT-Encoder seine volle Leistungsfähigkeit bei Segmentierungsaufgaben entfalten kann. Konkret geht es dabei um den Encoder-only Mask Transformer (EoMT), der das konventionelle Verständnis von Bildsegmentierung mit Transformern herausfordert und neue Maßstäbe bei Effizienz und Genauigkeit setzt.

Traditionell erfordern Segmentierungsmodelle oft komplexe Architekturkomponenten, die auf die mehrskalige Struktur von Bilddaten eingehen. Dazu gehören beispielsweise konvolutionale Adapter, die ViT-Ausgaben auf verschiedene Auflösungen projizieren, sowie spezielle Decoder-Mechanismen, die die gewonnenen Merkmale zusammenführen, um präzise Pixelsegmentierungen zu erreichen. Diese Komponenten bringen neben Rechenaufwand auch zusätzliche Komplexität mit sich, die Entwicklung, Training und Optimierung der Modelle erschweren können. Die konventionelle Auffassung war lange Zeit, dass ohne solche bauspezifischen Anpassungen ViTs im Bereich der Segmentierung nicht konkurrenzfähig sind. Die Erkenntnis der jüngsten Forschung kehrt diese Annahme um: Sie zeigt, dass der ViT-Encoder selbst bei großen Modellen und ausgiebigem Pre-Training Invarianzen und Mechanismen lernt, die üblicherweise erst durch spezielle Segmentation-Module erreicht werden.

Beispielsweise lernt der Transformer beim Pre-Training eine differenzierte semantische Repräsentation, die eine Pixel-genaue Segmentierung direkt ermöglicht, ohne dass ein zusätzlicher Decoder mit multiplen Feature-Streams nötig ist. Dadurch lässt sich das Modell erheblich verschlanken, was sich in deutlich reduzierten Inferenzzeiten äußert – so ist der EoMT im Vergleich zu herkömmlichen Verfahren bis zu viermal schneller, besonders bei großen ViT-Varianten wie ViT-L. Diese radikale Vereinfachung der Architektur bringt mehrere Vorteile mit sich: Neben der Beschleunigung im Deployment werden auch die Anforderungen an Ressourcen wie Speicher und Rechenleistung reduziert. Dies bedeutet, dass leistungsfähige Bildsegmentierung künftig auch auf Geräten mit begrenzten Ressourcen realisierbar ist, was gerade für Anwendungen in mobilen Endgeräten, autonomen Fahrzeugen oder Echtzeitanalysen von großer Bedeutung ist.

Darüber hinaus können Entwickler und Forscher ihre Ressourcen verstärkt in die Skalierung und Verbesserung der Kern-Transformer-Architektur stecken, anstatt komplexe zusätzliche Module zu konstruieren und zu optimieren. Ein weiterer wichtiger Aspekt ist die Skalierbarkeit und Flexibilität des EoMT-Ansatzes. Der Verzicht auf aufwändige Komponenten wie Pixel-Decoder macht ihn modular und adaptierbar für verschiedene Datensätze und Aufgabenstellungen, ohne dass umfangreiche architektonische Anpassungen notwendig sind. Dies vereinfacht die Anpassung und Integration in bestehende Workflows zur Bildsegmentierung enorm und spart wertvolle Entwicklungszeit. Die beeindruckende Leistung des EoMT wurde durch umfangreiche Experimente auf diversen Benchmark-Datensätzen unterstrichen. Dabei konnten die Forscher zeigen, dass die Segmentierungsgenauigkeit des EoMT mit etablierten State-of-the-Art-Modellen, die auf speziellen, komplexen Architekturen basieren, vergleichbar ist.

Gleichzeitig führte der vereinfachte Aufbau zu einer deutlich besseren Geschwindigkeit bei der Vorhersage, was besonders für Anwendungen mit Echtzeitanforderungen und hohem Durchsatz von Bedeutung ist. Neben der technischen Performance wirft die neue Perspektive auf die ViT-Architektur auch grundlegende Fragen zur Rolle von Induktionsbiases in neuronalen Netzen auf. Induktionsbiases sind Vorannahmen oder architektonische Eigenschaften, die Netzwerke dazu bringen, Muster und Strukturen in den Daten leichter zu erkennen. Bislang wurden sie oft explizit durch Architekturdesign eingeführt, wie etwa durch konvolutionsbasierte Schichten oder mehrskalige Verarbeitungswege. Die Tatsache, dass ein rein transformerbasierter Encoder dank umfangreichem Pre-Training diese Biases implizit lernbar macht, deutet auf eine neue Ära in der Modellgestaltung hin – weg von handgefertigten Feature-Designs hin zu skalierbaren, rechenintensiven Modellen, die ihre eigenen Repräsentationen herstellen.

Für die praktische Nutzung bedeutet dies, dass Entwickler in Zukunft einfachere Pipeline-Strukturen realisieren können, in denen weniger Spezialkomponenten den Entwicklungsprozess begleiten. Die Entwicklung und Wartung von Bildsegmentierungsmodellen wird dadurch nicht nur schneller und kosteneffizienter, sondern auch weniger fehleranfällig. Gleichzeitig eröffnet die Fähigkeit zur Skalierung mit wenig zusätzlicher Architektur neue Möglichkeiten für Forschung und Industrie, um noch größere Transformer-Modelle für verschiedene visuelle Aufgaben zu trainieren und zu nutzen. Insgesamt markiert die Arbeit an EoMT einen Wendepunkt in der Anwendung von Vision Transformern für Segmentierungsaufgaben. Sie zerstört die bisher weit verbreitete Vorstellung, dass ViTs ohne zusätzliche Bausteine nicht für Pixelgenauigkeit geeignet sind.

Stattdessen präsentiert sie eine elegante und gleichzeitig äußerst leistungsfähige Lösung, die zeigt, wie durch reines Pre-Training und Skalierung ein einfacher Transformer-Encoder zum vielseitigen Bildsegmentierer wird. Diese Erkenntnisse dürften die Entwicklung der Computer Vision nachhaltig beeinflussen. Künftig wird weniger der architektonische Aufwand über den Erfolg bestimmen, sondern verstärkt die Größe und Qualität des Pre-Trainings, verbunden mit effizienten Trainierungsstrategien. Dies ist eine spannende Aussicht, die die Grenzen zwischen verschiedenen Aufgaben und Modellen weiter verwischen lässt und Raum für Innovationen bietet. Abschließend lässt sich festhalten, dass Vision Transformer nicht nur ein starkes Werkzeug für die Bildklassifikation sind, sondern grundsätzlich als umfangreiche Repräsentationsmodellierer fungieren, die dank modifizierter Trainingsparadigmen mühelos auch in der Segmentierung brillieren können.

Die Einführung des Encoder-only Mask Transformer steht dabei exemplarisch für diesen Paradigmenwechsel, der eine neue Generation einfacher, schneller und dennoch hochpräziser Bildsegmentierungsmodelle einläutet.
OKX Partnerinhalte

Registrieren Sie sich bei OKX und erhalten Sie Ihren Willkommensbonus

OKX ist eine Plattform für Spot- und Futures-Handel, P2P-Tausch und Krypto-Sparpläne. Ein neues Konto über diesen Link eröffnet Zugang zum Willkommensbonus-Programm: bis zu 10.000 USDT für Ihre ersten Schritte an der Börse.

Konto erstellen und Bonus erhalten →

18+ · Partnerlink. Kryptowährungen sind volatil: Sie können Ihre Einlage verlieren.

Als Nächstes
Vitalik Buterin skizziert Zukunftsvision: Ethereum-Ökosystem erreicht neuen Höchststand bei Adressen
Samstag, 14. November 2026. Vitalik Buterin skizziert Zukunftsvision: Ethereum-Ökosystem erreicht neuen Höchststand bei Adressen

Ethereum hat in den letzten Jahren eine beeindruckende Entwicklung durchlaufen und ist längst nicht mehr nur eine Kryptowährung, sondern eine umfassende Plattform für Smart Contracts, dezentrale Applikationen (dApps) und vielfältige Blockchain-Anwendungen. Vor Kurzem hat der Mitbegründer Vitalik Buterin einen weiteren bedeutenden Meilenstein für das Ethereum-Ökosystem bekannt gegeben: Die Anzahl der einzigartigen aktiven Adressen im Netzwerk hat mit über 15,4 Millionen einen neuen Höchststand erreicht.

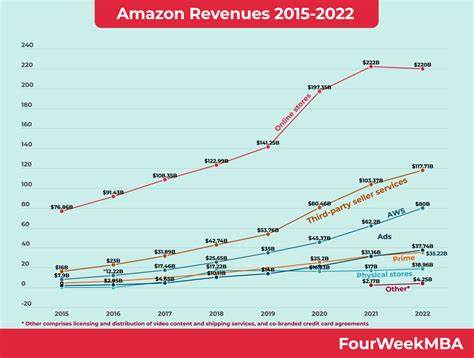
Amazon: Teuer oder doch ein Schnäppchen? Drei Charts, die Ihre Meinung ändern könnten
Samstag, 14. November 2026. Amazon: Teuer oder doch ein Schnäppchen? Drei Charts, die Ihre Meinung ändern könnten

Amazon ist mit einer Marktkapitalisierung von etwa zwei Billionen US-Dollar eines der wertvollsten und bekanntesten Unternehmen der Welt. Aufgrund seines hohen Aktienkurses und Kurs-Gewinn-Verhältnisses wird der Konzern von vielen Anlegern als zu teuer eingestuft.

Coinbase startet institutionellen Investmentfonds mit Bitcoin-Erträgen
Samstag, 14. November 2026. Coinbase startet institutionellen Investmentfonds mit Bitcoin-Erträgen

Die Kryptobörse Coinbase, eine der führenden Plattformen im Bereich des Kryptowährungshandels und der digitalen Vermögensverwaltung, kündigt die Einführung eines neuen institutionellen Fonds an, der Erträge auf Bitcoin-Investitionen bietet. Unter dem Namen Coinbase Bitcoin Yield Fund richtet sich dieses neue Finanzprodukt speziell an institutionelle Anleger außerhalb der USA und bietet das Potenzial für eine jährliche Rendite zwischen 4 und 8 Prozent, ausgezahlt in Bitcoin.

Datadog, Inc. (DDOG): Ein Blick auf die vielversprechende Aktie des Milliardärs Chase Coleman
Samstag, 14. November 2026. Datadog, Inc. (DDOG): Ein Blick auf die vielversprechende Aktie des Milliardärs Chase Coleman

Datadog, Inc. (DDOG) steht aktuell im Fokus von Investoren, die auf zukunftsträchtige Technologiewerte mit bedeutendem Wachstumspotenzial setzen.

Wie Riot Games den Kampf gegen Videospiel-Hacker gewinnt: Ein Blick auf Vanguard und Anti-Cheat-Strategien
Samstag, 14. November 2026. Wie Riot Games den Kampf gegen Videospiel-Hacker gewinnt: Ein Blick auf Vanguard und Anti-Cheat-Strategien

Seit den Anfängen von Videospielen war das Thema Cheating stets ein Schatten, der die Spielerfahrung trübte. Doch mit der Professionalisierung des Online-Gaming, insbesondere im eSports-Bereich, hat sich der Kampf gegen Hacker und Betrüger zu einer regelrechten Schlacht entwickelt.

El Cono: Das geheimnisvolle heilige 'Pyramide' im Herzen des Amazonas-Regenwaldes
Samstag, 14. November 2026. El Cono: Das geheimnisvolle heilige 'Pyramide' im Herzen des Amazonas-Regenwaldes

Mitten im dichten Amazonas-Regenwald im Osten Perus erhebt sich ein außergewöhnliches Naturphänomen: Cerro El Cono. Diese einsame, fast perfekt konische Erhebung hebt sich markant von der umliegenden, vergleichsweise flachen Dschungellandschaft ab und fasziniert Wissenschaftler, Entdecker und Kulturinteressierte gleichermaßen.

N-Acetylcystein (NAC): Die Aminosäure, die die Psychiatrie revolutioniert
Samstag, 14. November 2026. N-Acetylcystein (NAC): Die Aminosäure, die die Psychiatrie revolutioniert

Die Psychiatrie steht seit Jahrzehnten vor einer fundamentalen Frage: Sind psychische Erkrankungen völlig unterschiedliche Zustände mit klar getrennten Symptomen oder gibt es gemeinsame biologische Grundlagen, die viele dieser Störungen verbinden. Diese Debatte zwischen sogenannten „Lumpern“ und „Splittern“ prägt die Forschung und klinische Behandlung bis heute.

Weitere Artikel zum Thema
Trader setzen verstärkt auf nur eine Zinssenkung der Fed im Jahr 2025 vor den CPI-Daten
Samstag, 14. November 2026. Trader setzen verstärkt auf nur eine Zinssenkung der Fed im Jahr 2025 vor den CPI-Daten

Die Finanzmärkte weltweit beobachten mit großer Spannung die weitere Ausrichtung der Geldpolitik der US-Notenbank Federal Reserve (Fed). In den letzten Wochen ist deutlich geworden, dass Trader vermehrt ihre Wetten auf eine einzelne Zinssenkung im Jahr 2025 konzentrieren.

Worldcoin Preisprognose 2024-2030: Lohnt sich die Investition?
Freitag, 13. November 2026. Worldcoin Preisprognose 2024-2030: Lohnt sich die Investition?

Die Zukunft von Worldcoin: Preisprognose 2024-2030 – Eine lohnende Investition. In den letzten Jahren hat sich der Kryptowährungsmarkt rasant entwickelt und zahlreiche Projekte hervorgebracht, die das Potenzial haben, die Finanzwelt zu revolutionieren.

Tether prägt 19 Milliarden USDT in einem Monat – Was bedeutet das für den Kryptomarkt?
Samstag, 14. November 2026. Tether prägt 19 Milliarden USDT in einem Monat – Was bedeutet das für den Kryptomarkt?

In der dynamischen Landschaft der Kryptowährungen sorgt die Ankündigung von Tether, innerhalb eines Monats 19 Milliarden USDT (Tether-Dollar) geprägt zu haben, für erhebliches Aufsehen und Besorgnis. Tether ist eine der größten Stablecoins weltweit und dient als digitale Alternative zum US-Dollar, die von vielen Tradern und Investoren als stabiles Wertaufbewahrungsmittel genutzt wird.

Europa bereitet sich 2026 auf umfassende Regulierungen von DeFi vor – MiCA lässt Branche im Unklaren
Samstag, 14. November 2026. Europa bereitet sich 2026 auf umfassende Regulierungen von DeFi vor – MiCA lässt Branche im Unklaren

In der dynamischen Welt der Kryptowährungen nimmt die Regulierung eine immer bedeutendere Rolle ein, insbesondere wenn es um dezentrale Finanzsysteme (DeFi) geht. Europa plant, ab 2026 konkrete Regulierungen für DeFi einzuführen, nachdem der bisher wegweisende Rechtsrahmen MiCA (Markets in Crypto-Assets Regulation) ab Ende 2024 in Kraft getreten ist.