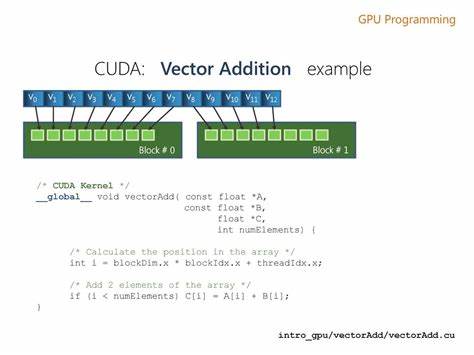
Die Berechnung von Vektorsummen, auch als Vektorreduktion bekannt, ist eine essentielle Operation in der wissenschaftlichen Berechnung und Machine Learning. Für viele Entwickler steht dabei häufig CUDA als de-facto-Standard für GPU-Berechnungen im Fokus. Doch es ist möglich, auch ohne CUDA eine beeindruckende Leistung auf GPUs zu erzielen. Die Programmiersprache Mojo eröffnet hier neue Wege, um hochperformante Vektorreduktionen auf modernen GPUs wie der NVIDIA H100 Hopper Architektur durchzuführen und so die Speicherbandbreite nahezu auszuschöpfen. Das grundlegende Prinzip hinter Vektorreduktionen besteht darin, große Datenmengen effizient zu summieren. Eine naive Herangehensweise unterteilt das Problem in zwei Stufen. Zunächst summieren viele Threads in einer Parallelverarbeitung Teile des Vektors, dann erfolgt eine zweite Reduktion, die das Zwischenergebnis zu einem einzelnen Skalarwert zusammenfasst.
Dieses zweistufige Vorgehen lässt sich leicht in Mojo mittels eines parallelisierten Kernels abbilden. Innerhalb des Kernels wird ein Shared-Memory-Array angelegt, welches der Blockgröße TPB entspricht und für die Zwischensummen jeder Thread-Gruppe dient. Jeder Thread sammelt während seiner Iterationen über den Inputvektor einzelne Werte und speichert die Teilsumme. Nach einer Synchronisation erfolgt die Reduktion der Zwischensummen durch sukzessives Addieren benachbarter Werte mithilfe einer Parametric For-Schleife in Mojo. Dieser Ablauf ähnelt stark den klassischen CUDA-Implementierungen, bei denen das Zusammenspiel von Threads über __syncthreads optimiert wird. Obwohl dieser naive zweistufige Ansatz bereits valide Ergebnisse liefert, sind in der Performance noch Verbesserungen möglich. So lassen sich beispielsweise am Ende der Reduktion Warps, also Subgruppen von 32 Threads, ohne Synchronisation mittels spezieller Warp-Shuffle-Operationen zusammengeführt werden.
Diese Operationen sind in Mojo als abstrakte Funktionen wie warp. sum implementiert, die letztendlich auf optimierte PTX-Instruktionen zurückgreifen und damit teure Block-Synchronisationen einsparen. Durch die Nutzung solcher Warp-Shuffles erhöhen sich die Speicherbandbreiten-Auslastung und somit die GPU-Effizienz signifikant. Tests zeigen, dass auf einer NVIDIA H100 der Datendurchsatz von etwa 622 GB/s auf über 718 GB/s steigen kann. Auch auf Verbraucher-Grafikkarten wie einer RTX 3060 lässt sich die Performance mit diesen Optimierungen deutlich steigern. Während der zweistufige Pipeline-Ansatz die Implementierung vereinfacht, verursacht er durch mehrere Kernel-Launches auch einen gewissen Overhead. Eine weitere Steigerung der Effizienz erreicht man durch einen Ein-Pass-Ansatz, bei dem die Zwischenergebnisse aller Blöcke atomar auf das finale Ergebnis addiert werden.
Das ist technisch anspruchsvoller, da Atomanweisungen notwendig sind, um gleichzeitig schreibende Threads korrekt zu synchronisieren. In Mojo steht mit Atomic. fetch_add eine leistungsfähige Funktion zur Verfügung, die genau dies ermöglicht. Der Kernel bleibt weitgehend unverändert, am Ende wird jedoch die Blocksumme über alle Blöcke hinweg atomar aufs Endergebnis addiert. Diese Vereinfachung beim Nutzer führt auf der NVIDIA H100 zu einer nochmals deutlich verbesserten Leistung von fast 985 GB/s. Die GPU-Auslastung steigt hier auf über 29 %, was bei einer speicherbandbreitenlastigen Anwendung beachtlich ist. Für Speicherbandbreiten-limitierte Algorithmen ist es üblich, die Arbeitslast pro Thread durch Batch-Processing zu erhöhen. Das bedeutet, dass jeder Thread mehrere aufeinanderfolgende Elemente abarbeitet statt nur einzelner Elemente. In Mojo lässt sich dies durch eine kleine Schleife innerhalb des Kernels realisieren, die je nach Batch-Größe mehrere Arrayelemente summiert.
Dieser Ansatz sorgt für eine bessere Ausnutzung der Speicherzugriffe und reduziert die Kosten von Zuweisungen und Schleifensteuerungen. Der Effekt ist spürbar: Auf modernen konsumerorientierten GPUs klettert der Datendurchsatz durch dieses Thread-Batching auf über 320 GB/s, auf der High-End Hopper-Architektur liegt der Wert sogar bei über 1800 GB/s. Diese riesigen Geschwindigkeiten sind Ausdruck der enormen Leistungsfähigkeit moderner GPU-Hardware und der effektiv abgestimmten Software. Eine weitere entscheidende Maßnahme, um die Speichereffizienz zu maximieren, ist die Verwendung von vektorisierten Speicherzugriffen. In CUDA sind etwa Datentypen wie int4 bekannt, die in einem Lesezugriff 128 Byte gleichzeitig abdecken und so den Speichercontroller optimal nutzen. Mojo bietet mit der Funktion load einen ähnlich leistungsfähigen Mechanismus, der paralleles Laden von mehreren Zahlen ermöglicht und dabei unterschiedliche Cache-Strategien unterstützt.
Die Kombination aus vektorisierten Lesezugriffen, Batch-Verarbeitung und Warp-Shuffle-basierten Reduktionen ermöglicht bei Tests auf der Hopper GPU Speicherdurchsätze von über 3100 GB/s und damit eine GPU-Auslastung von fast 95 %. Diese Werte liegen kaum noch unterhalb der Performance der spezialisiertesten CUDA-Bibliotheken wie CUB, was eindrucksvoll die Qualitätsfähigkeit von Mojo unterstreicht. Mojo ist dabei nicht nur auf NVIDIA-GPUs beschränkt. Die prinzipielle Architektur und Programmiermodelle erlauben es, diese Ansätze auch auf AMD GPUs und anderen Plattformen zu übertragen. Damit eröffnet die Sprache ein sehr flexibles Ökosystem für Entwickler, die ohne tiefes Eintauchen in CUDA dennoch hochoptimierte GPU-Programme schreiben möchten. Die Anwendungsszenarien einer schnellen Vektorreduktion sind immens vielfältig.
Sei es als Basisoperation bei maschinellem Lernen, Datenanalyse, wissenschaftlicher Simulation oder Grafikanwendungen – eine optimierte Summation großer Datenmengen ist unverzichtbar. Mojo bietet damit nicht nur eine leistungsfähige Alternativen zu etablierten CUDA-Lösungen, sondern auch eine zukunftsorientierte Plattform für heterogene Hardware und neue Programmiersprachen-Paradigmen. Es gibt allerdings noch Raum für weitere Optimierungen und Feintuning, etwa durch gezielte Analyse des erzeugten LLVM Intermediate Representations oder Assemblercodes. Solche Optimierungen können helfen, den Code noch näher an die Hardwaregrenzen zu bringen. Jedoch zeigen die aktuellen Resultate bereits, dass mit vergleichsweise minimalem Aufwand und sauberer Architektur große Leistungsfortschritte erzielt werden können. Zusammenfassend sind hochperformante Vektorreduktionen auf GPUs kein exklusives Vorrecht von CUDA mehr.
Moderne Programmiersprachen wie Mojo eröffnen Wege, Funktionen wie Atomoperations, Warp-Shuffle und Shared Memory effektiv zu nutzen, um auch ohne CUDA eine hervorragende Performance zu erzielen. Für Entwickler bedeutet das mehr Flexibilität in der Hardwarewahl und einfacher wartbaren Code bei zugleich beeindruckender Geschwindigkeit. Der Einsatz von Batch-Größen und vektorisierten Speicherzugriffen zeigt exemplarisch, wie wichtig softwareseitiges Feintuning im Zusammenspiel mit moderner GPU-Architektur ist. Zukünftige Entwicklungen in der GPU-Programmierung werden vermutlich immer mehr in diese Richtung gehen. Die Kombination aus leistungsfähigen abstrahierten Sprachen, Hardware-agnostischen Programmiermodellen und tiefem Verständnis der Hardware ermöglicht es, die extremen Parallelisierungspotenziale optimal auszunutzen. Projekte wie Mojo zeigen heute schon, dass diese Vision keine Zukunftsmusik mehr ist, sondern Realität auf aktuellen GPUs.
Für Anwender und Entwickler lohnt es sich daher, die Möglichkeiten von Mojo zur Vektorreduktion näher anzuschauen, sei es über offizielle Repositories oder weiterführende Dokumentationen. Mit ihnen lassen sich nicht nur klassische CUDA-Kernel nachbauen, sondern durch clevere Optimierungen auch übertreffen. Gerade für rechenintensive Workloads sind solche Kenntnisse ein klarer Wettbewerbsvorteil in der High-Performance-Computing-Landschaft. So zeigt der Weg von der einfachen zweistufigen Reduktion, über Warp-Shuffle-basierte Ein-Pass-Varianten, bis hin zu batch-basierten und vektorisierten Speicherzugriffen, wie sich die Effizienz Schritt für Schritt steigern lässt. Die Kombination aus behutsamer Software-Architektur und moderner Hardware eröffnet dabei Potenziale, die etwa durch eine Auslastung von bis zu 95 % der Speicherbandbreite auf topaktuellen GPUs offensichtlich werden.
Abschließend bleibt festzuhalten, dass die Zukunft der GPU-Programmierung nicht zwangsläufig ausschließlich von Hardwareherstellern geprägt wird. Offene und innovative Programmiersprachen wie Mojo, kombiniert mit cleveren Algorithmen, ermöglichen es vielen Entwicklern, leistungsfähige Anwendungen zu bauen, die GPU-Potentiale besser ausschöpfen und dabei auch in Zukunft flexibel mit neuen Plattformen kompatibel bleiben. Die Zeit von CUDA als einziger GPU-Sprache neigt sich somit dem Ende zu – die Ära von sauber abstrahiertem, performantem GPU-Computing hat begonnen.