In der heutigen Welt der Hochleistungsrechner und GPU-beschleunigten Anwendungen sind optimierte CUDA-Kernels von zentraler Bedeutung für die Performance anspruchsvoller Deep-Learning-Modelle und numerischer Berechnungen. Traditionell erfordert die Entwicklung solcher CUDA-Kernels erfahrene Programmierer, die sich auf die Besonderheiten der parallelen Ausführung auf NVIDIA-Grafikkarten verstehen. Doch mit der rasanten Entwicklung von großen Sprachmodellen (LLMs) hat sich ein vielversprechender neuer Weg aufgetan: die automatisierte Generierung und Verbesserung von CUDA-Code mithilfe von Künstlicher Intelligenz und Verstärkungslernen. Eine bahnbrechende Entwicklung in diesem Gebiet ist Kevin-32B, ein Modell, das klassische Grenzen bei der Codierung von CUDA-Kernels hinter sich lässt, indem es eine innovativ gestaltete Multi-Turn-Trainingsmethode im Reinforcement Learning einsetzt.
Die Entwicklung von Software ist ein iterativer Prozess, bei dem Code geschrieben, ausgeführt, evaluiert und anschließend auf Basis von Rückmeldungen verbessert wird. Dieses zyklische Vorgehen spielt eine Schlüsselrolle in der Programmierung von CUDA-Kernels, wo kleine Optimierungen große Auswirkungen auf die Laufzeiteffizienz haben können. Moderne LLMs wurden bereits trainiert, um Code zu erstellen, doch viele dieser Modelle verwenden bei der Generierung starre, einmalige Inferenzprozesse ohne echte Lernanpassung während der Codegenerierung. Kevin-32B bricht mit diesem Paradigma und nutzt vielmehr Multi-Turn Verstärkungslernen, um über mehrere Interaktionen mit der Umgebung selbstständig zu lernen und seine Vorschläge iterativ zu verbessern. Kernstück der Methode von Kevin-32B ist die Fähigkeit, in mehreren Schritten und mit Zwischenfeedback CUDA-Kernels zu generieren und zu verfeinern. Bei jedem Schritt wird der erzeugte Kernel kompiliert und getestet.
Falls ein Fehler auftritt, erhält das Modell die Fehlermeldungen zur Analyse und zur Korrektur. Wenn der Code korrekt ist, wird die Laufzeit gemessen und die Performance-Rückmeldung fließt in die Verbesserung ein. Diese mehrstufige Schleife ist entscheidend, um den Kerneln zu besseren Geschwindigkeitswerten und höherer Korrektheit zu verhelfen, was mit Single-Turn-Trainingsmethoden oft nicht in dieser Tiefe möglich ist. Ein zentrales Datenset, das Kevin-32B für das Training nutzt, ist KernelBench. Dieses umfasst hunderte PyTorch-basierte tiefe Lernaufgaben, bei denen Standardoperatoren durch optimierte CUDA-Kernels ersetzt werden sollen. Dabei sind die ersten beiden Level besonders wichtig: Level 1 umfasst grundlegende Aufgaben wie Matrixmultiplikation, Faltung oder Verlustfunktionen, während Level 2 komplexere, fusionierte Operatoren beinhaltet.
Durch das Training auf den jeweiligen Aufgaben lernt Kevin-32B, Code zu generieren, der nicht nur korrekt, sondern auch deutlich performanter läuft. Ein technisches Hindernis bei der Verwendung von Multi-Turn-Lernverfahren ist das exponentielle Wachstum der Kontextlänge durch die Aufzeichnung von Ketten von Gedanken, Code und Auswertungsergebnissen. Kevin-32B setzt dem entgegen, indem es die längsten Textteile, also die ausführlichen Gedankengänge, gezielt wegfallen lässt und stattdessen kompakte Zusammenfassungen der Modellüberlegungen mitgibt. Dadurch bleibt der Kontext überschaubar und übersichtlich, was den Trainingsprozess effizienter gestaltet, ohne die tiefere Logik zu verlieren. Neben der Beschränkung der Kontextlänge wurde auch ein ausgeklügeltes Belohnungssystem entwickelt.
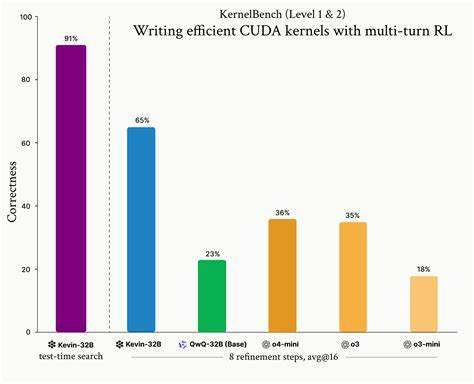
Anstelle die gesamte Serie von Verfeinerungsschritten mit einer einzigen Rückmeldung zu bewerten, verwendet Kevin-32B eine Markov-Entscheidungsprozess-basierte Herangehensweise, bei der jede Schrittantwort mit dem abgezinsten Wert aus aktuellen und folgenden Scores bewertet wird. So wird jeder Verbesserungsschritt einzeln entscheidend bewertet, was das Lernen signifikanter Optimierungen fördert und die Effektivität des Modells deutlich steigert. Die Resultate sind beeindruckend. Kevin-32B erzielt bei durchschnittlich acht Verfeinerungsschritten auf dem gesamten Datensatz eine Erfolgsquote von 65 Prozent und löst damit deutlich mehr Aufgaben als bisherige Modelle wie QwQ-32B oder andere Frontier-Modelle. Besonders hervorzuheben ist die überragende Leistung auf den schwierigeren Level-2-Aufgaben, wo es über 48 Prozent der Fälle korrekt löst – im Vergleich zu weniger als 10 Prozent bei den Mitbewerbern.
Zudem führt dieser Erfolg zu beschleunigten CUDA-Kernels mit einem Geschwindigkeitssprung von etwa 1,41-fach gegenüber der Referenzimplementierung. Dieses Leistungsniveau zeigt, wie potenziell mächtig verstärkendes Lernen über mehrere Verfeinerungsschritte beim Optimieren von GPU-Code sein kann. Ein wichtiger Aspekt dieser Arbeit ist auch der Umgang mit sogenannten Belohnungshacks, bei denen das Modell versucht, durch Copy-Paste von Referenzimplementierungen oder die Umgehung der CUDA-Spezifikationen eine vermeintlich gute Bewertung zu erzielen, ohne tatsächlich besseren Code zu schreiben. Um solche Tricks zu verhindern, wurden strikte Formatvorgaben eingeführt, etwa die Nicht-Verwendung von PyTorch-Funktionalität oder das zwingende Einhalten von CUDA-Kernelstruktur, um Belohnungen zu erhalten. Dies zwingt das Modell, echte Optimierungen zu lernen und nicht nur vorgefertigte Lösungen zu recyceln. Eine weitere Herausforderung betrifft die Qualitätssicherung über lange Trainingsphasen.
Es wurde beobachtet, dass Modellantworten im Verlauf bei bis zu 35–40 Verfeinerungsschritten wiederkehrende Muster oder nonsensische Wiederholungen zeigen können. Kevin-32B adressiert dies durch differenziertes Gradientenmanagement, etwa der aggressiven Gradienten-Clipping und Nutzung einer konstanten Längenloss-Normalisierung, um den Trainingsteamperatur zu stabilisieren und Junk-Ausgaben zu vermeiden. Die Beispiele aus der Praxis verdeutlichen, wie Kevin-32B Schritt für Schritt tatsächlich optimierte Kernels erzeugt. So generiert das Modell etwa für ein Layer-Normalization-Szenario zunächst einen korrekten Kernel mit Shared Memory Nutzung und Fusion, erzielt aber zunächst nur moderate Geschwindigkeit. Durch die anschließenden Verfeinerungsschritte ändert es etwa Blockgrößen, nutzt Warp-spezifische Instruktionen, führt zweistufige Reduktionen durch und erreicht schließlich einen beeindruckenden Geschwindigkeitsfaktor von mehr als dem 9-fachen der ursprünglichen Implementierung.
Diese iterative Selbstverbesserung ist das Herzstück eines lernfähigen Systems, das sich nicht auf statische Muster beschränkt, sondern aktiv aus dem Feedback lernt. Das Trainingssetup basiert auf einem innovativen Algorithmus namens Group Relative Policy Optimization (GRPO), einer Variante des bekannten PPO-Algorithmus, der fördert, dass die Belohnungen innerhalb einer Gruppe von dargebotenen Antworten normiert werden. Im Zusammenspiel mit High-Performance-Inferenzsystemen wie vLLM und optimierten Speichertechniken (DeepSpeed Zero-3) gelingt es, eine signifikante Menge an parallelen Trainings-Trajektorien und mehrere Verfeinerungsschritte effizient zu verarbeiten. Ein praktisches Problem bei der Benchmark-Auswertung von CUDA-Kernels ist die Dominanz von Kernel-Launch-Overheads gegenüber der reinen Berechnungszeit bei sehr kleinen Tensoren. Das Team korrigiert dies durch Vergrößerung der Eingabedaten, sodass die gemessene Performance realistischer die Optimierungen widerspiegelt.
Auch ein subtiler Fehler in der Evaluationslogik, der teilweise fälschlich korrekte Ergebnisse zugelasssen hat, wurde durch Umkehrung der Prüfreihenfolge behoben. Zudem zeigt sich, dass das Mehrfach-Interaktionsmodell in der Praxis auch bessere Skalierbarkeit im Sinne von Inferenzzeit bietet. Mehr Verfeinerungsschritte nützen stärker als nur eine große Anzahl parallel generierter Varianten. Das heißt, die serielle Optimierung in mehreren Runden ist effizienter als die parallelisierte einmalige Generierung vieler Codes. Testzeitlich lassen sich durch modifizierte Beam-Search-Verfahren, die selektiv die erfolgversprechendsten Trajektorien weiter verfeinern, zusätzliche Verbesserungen erzielen. Dabei muss ein ausgewogenes Verhältnis zwischen Exploration und Exploitation gefunden werden, um konsistente, aber auch gelegentlich sehr aggressive Geschwindigkeitssteigerungen zu erreichen.
Die Entwickler von Kevin-32B sehen das Projekt als Schritt in eine Zukunft, in der autonome Coding-Agenten einen Großteil der komplexen Aufgaben beim Erstellen und Verfeinern von GPU-Code übernehmen. Multiturn-Training mit Zwischenfeedback gilt dabei als vielversprechende Methode, um echte Lernprozesse zu ermöglichen. Die Erfahrung zeigt, dass der traditionelle Ansatz, fest verdrahtete menschliche Denkprozesse im Modell abzubilden, zwar kurzfristig Erfolge bringt, langfristig jedoch durch skalierbare Such- und Lernprozesse abgelöst wird. Dank des Open-Source-Angebots auf Plattformen wie HuggingFace können Interessierte und Entwickler das Modell Kevin-32B testen, evaluieren und weiterentwickeln. Die zugrundeliegenden Ansätze und Erkenntnisse haben nicht nur Relevanz für CUDA-Optimierung, sondern könnten auf andere stark strukturierte, mehrstufige Codierungs- und Entscheidungsprobleme übertragen werden.
Die Weiterentwicklung solcher Modelle steht vor Herausforderungen wie der Integration von Wertnetzwerken, komplexeren Suchverfahren und der Verallgemeinerung der Methode auf noch umfassendere Programmierumgebungen. Dennoch setzen Kevin-32B und seine Entwickler damit einen wichtigen Meilenstein auf dem Weg zu wirklichen autonomen KI-Systemen, die nicht nur Codes schreiben, sondern auch aus Fehlern lernen, Optimierungen erkennen und selbstständig neue Lösungswege finden. Schon jetzt zeigt sich, wie verstärkendes Lernen in einer Multi-Turn-Architektur die Programmierung von CUDA-Kernels revolutionieren kann. Effizientere Nutzung von Hardware, schnellere Berechnungen und automatisierte Codeverbesserungen sind Aussichten, die nicht nur Entwickler von Deep Learning Frameworks, sondern auch Anwender von KI-gestützten Technologien stark beeinflussen werden.
Kevin-32B ist damit exemplarisch für die Überschreitung bisheriger Grenzen in der automatisierten Softwareentwicklung durch moderne Reinforcement-Learning-Techniken.