Nachrichten zur Krypto-Börse

Groß angelegte Wettbewerbsstrategien in Mehragentensystemen: Mean-Field-Interaktionen als Schlüssel zur Skalierbarkeit

Die Anwendung von Mean-Field-Theorie in Multiagentensystemen ermöglicht das Erlernen und Simulieren großer, wettbewerbsorientierter Teamverhalten. Die innovative Weiterentwicklung von Proximal Policy Optimization für Mean-Field-Umgebungen eröffnet neue Perspektiven für skalierbare und effiziente Agentensteuerung in komplexen Szenarien wie militärischen Simulationen.

Groß angelegte Wettbewerbsstrategien in Mehragentensystemen: Mean-Field-Interaktionen als Schlüssel zur Skalierbarkeit

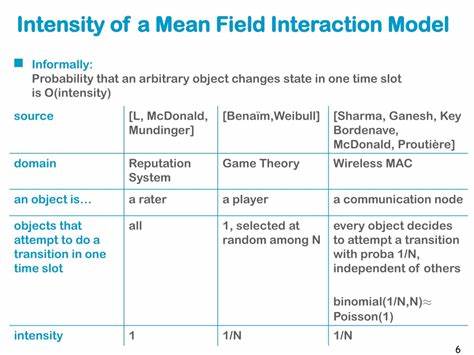
Im Bereich der Künstlichen Intelligenz und der Robotik gewinnt das Verständnis und die Steuerung von Multiagentensystemen zunehmend an Bedeutung. Besonders herausfordernd ist es, wenn es um den Einsatz von hunderten oder gar tausenden von Agenten geht, die in Wettbewerbsumgebungen agieren und komplexe Teamstrategien entwickeln müssen. Klassische Ansätze im Multiagenten-Reinforcement-Learning, wie MADDPG (Multi-Agent Deep Deterministic Policy Gradient) und MAAC (Multi-Agent Actor-Critic), stoßen hier an ihre Grenzen, da sie nicht effizient mit der steigenden Agentenzahl skalieren. Aus genau diesem Grund ist die Mean-Field-Theorie zu einem fokusbildenden Konzept geworden, das auf makroskopischer Ebene eine Annäherung an die Population von Agenten und deren Interaktionen mit der Umgebung ermöglicht. Mean-Field-Methoden betrachten die kollektive Wirkung eines Agentenfeldes anstatt auf einzelne Agenten zu fokussieren und ebnen somit den Weg für robustes Lernen selbst in extrem großen Teams.

Das innovative Konzept der Mean-Field-Interaktionen beruht darauf, dass in sehr großen Systemen das Verhalten eines einzelnen Agents kaum das Gesamtergebnis beeinflusst, vielmehr ist es die Verteilung und der aggregierte Einfluss aller Agenten, der zählt. Dieser faktische Übergang zu einer Kontinuumsperspektive erlaubt die Verwendung von stochastischen Differentialgleichungen und anderen mathematischen Werkzeugen, um die Dynamiken und optimalen Strategien zu erlernen. Die Herausforderung bestand bisher darin, diese Theorie wirksam in praxisnahe und simulationsstarke Algorithmen zu integrieren, die nicht nur robuste Performanz garantieren, sondern auch eine hohe Skalierbarkeit bezüglich der Agentenzahl aufweisen. In dem jüngsten Fortschritt auf diesem Gebiet wurde die traditionelle Proximal Policy Optimization (PPO) - eine bewährte Methode im Reinforcement Learning - erweitert und an die Anforderungen von Mean-Field-Interaktionen angepasst.

Das neue Verfahren mit dem Namen Mean-Field Multi-Agent Proximal Policy Optimization (MF-MAPPO) ermöglicht es, effiziente und stabile Lernprozesse selbst in kompetitiven Mehragentenumgebungen mit umfangreichen Teamgrößen umzusetzen. Dabei findet ein nullsummenbasiertes Spiel zwischen zwei gegnerischen Teams statt, bei dem für jedes Team das Ziel besteht, die optimale Gesamtstrategie in einem dynamischen Umfeld zu erfassen. Die Stärke von MF-MAPPO liegt darin, dass es die Wirksamkeit der finite-Population-Mean-Field-Approximation nutzt, um die Komplexität bei der Berechnung der Interaktionen drastisch zu reduzieren. Anstelle von internen Berechnungen zwischen einzelnen Agenten werden Mittelwerte über die Population herangezogen, wodurch das Modell auch bei 1000 oder mehr Agenten pro Team rechenbar bleibt. Dies ist ein enormer Vorteil gegenüber traditionellen MARL-Algorithmen, deren Rechenaufwand exponentiell mit der Anzahl der Agenten wächst.

Die Anwendungsgebiete für solche Algorithmen sind breit gefächert. Besonders im militärischen Kontext, wie bei groß angelegten Offensiv- und Defensivszenarien, bieten sich vielfältige Einsatzmöglichkeiten. Hier können realistische Simulationen von Kampfsituationen, Taktikentwicklung und Ressourcenmanagement erfolgen, die nicht nur akademischen, sondern auch praktischen Nutzen besitzen. Systeme, die in der Lage sind, komplexe Mehragenteninteraktionen auf Team-Ebene effizient zu steuern, können zukünftige Entscheidungsprozesse auf strategischer Ebene stark verbessern. Neben militärischen Simulationen finden sich auch im zivilen Einsatzbereich wertvolle Potenziale. Autonome Fahrzeugflotten, verteilte Drohnenschwärme oder intelligente Verkehrsnetzsteuerungen profitieren vom modellbasierten Lernen großer Agenten-Mengen mit kompetitiven und kooperativen Komponenten. Die Mean-Field-Methodik bildet hierbei eine Brücke zwischen theoretischen Modellen und praxisorientierten Implementierungen.

Technologisch gesehen basiert die Umsetzung von MF-MAPPO auf moderner Deep-Learning-Infrastruktur. Durch den Einsatz neuronaler Netzwerke können komplexe Zustand-Richtlinien-Zuordnungen erlernt werden, die die individuellen Agentenhandlungen mit den aggregierten Makrodynamiken in Einklang bringen. Die Trainingsprozesse werden dabei durch optimierte Gradientenverfahren und spezielle Regularisierungen unterstützt, die das Lernen stabil und effizient gestalten. Darüber hinaus fördert die Skalierbarkeit von MF-MAPPO eine realistische Abbildung von Szenarien, die bisher nur eingeschränkt simuliert werden konnten. Die Möglichkeit, sowohl kooperative als auch konkurrierende Agententeams in großem Maßstab darzustellen, eröffnet Forschern und Entwicklern neue Horizonte bei der Gestaltung autonomer Systeme.

Der algorithmische Fortschritt kann so in verschiedenen Bereichen adaptive und resiliente Systeme hervorbringen, die sich dynamisch an wechselnde Umweltbedingungen und Gegnerstrategien anpassen. Eine zentrale Herausforderung bleibt allerdings die Validierung der entwickelten Strategien und Modelle. Die Komplexität der Umgebungen und die Vielzahl der Agenten lassen eine vollständige theoretische Absicherung schwierig erscheinen. Hier kommen umfangreiche Simulationsstudien und empirische Bewertungen ins Spiel, die zeigen, dass MF-MAPPO in einer Vielzahl von Szenarien robuste Leistungswerte erzielt und das Lernen stabil hält. Diese Ergebnisse sind oft der entscheidende Faktor bei der Akzeptanz solcher Algorithmen sowohl in der Forschung als auch in industriellen Anwendungen. Zukunftsorientiert eröffnen sich auch spannende Möglichkeiten durch die Kombination von Mean-Field-Ansätzen mit anderen modernen Technologien wie Transferlernen, Meta-Lernen und verteilte Optimierung.

Solche hybriden Ansätze könnten die Adaptivität und Effizienz weiter erhöhen und den Einsatz großer Mehragentensysteme noch vielseitiger gestalten. Abschließend lässt sich festhalten, dass die Integration der Mean-Field-Theorie in moderne Reinforcement-Learning-Algorithmen wie PPO eine vielversprechende Methode darstellt, um die Herausforderungen der Skalierbarkeit und Komplexität in wettbewerbsorientierten Mehragentensystemen zu meistern. Der Erfolg von MF-MAPPO zeigt, wie theoretische Konzepte in praxisnahe Algorithmen überführt werden können, um realitätsnahe Mehragentensimulationen mit extrem großen Teamgrößen zu ermöglichen. Diese Fortschritte bieten faszinierende Perspektiven für die Zukunft autonomer Systeme, in denen komplexe Teamdynamiken nicht nur simuliert, sondern auch effektiv gesteuert werden können.
OKX Partnerinhalte

Registrieren Sie sich bei OKX und erhalten Sie Ihren Willkommensbonus

OKX ist eine Plattform für Spot- und Futures-Handel, P2P-Tausch und Krypto-Sparpläne. Ein neues Konto über diesen Link eröffnet Zugang zum Willkommensbonus-Programm: bis zu 10.000 USDT für Ihre ersten Schritte an der Börse.

Konto erstellen und Bonus erhalten →

18+ · Partnerlink. Kryptowährungen sind volatil: Sie können Ihre Einlage verlieren.

Als Nächstes
Taiwan Semiconductor Manufacturing Company Limited (TSM): Ein Schlüsselunternehmen für Hedgefonds im Wachstumsmarkt
Samstag, 14. November 2026. Taiwan Semiconductor Manufacturing Company Limited (TSM): Ein Schlüsselunternehmen für Hedgefonds im Wachstumsmarkt

Die Taiwan Semiconductor Manufacturing Company Limited, kurz TSM, zählt zu den weltweit größten und bedeutendsten Herstellern von Halbleitern und Mikrochips. Das Unternehmen hat sich in den letzten Jahrzehnten eine dominierende Stellung im globalen Technologiemarkt erarbeitet und gilt als unverzichtbarer Partner für zahlreiche Branchen, darunter die Automobilindustrie, Unterhaltungselektronik und insbesondere die IT- und Kommunikationsbranche.

Republikanische Gesetzgeber unterstützen Plan zur Abschaffung des PCAOB: Auswirkungen auf die Wirtschaftsprüfung in den USA
Samstag, 14. November 2026. Republikanische Gesetzgeber unterstützen Plan zur Abschaffung des PCAOB: Auswirkungen auf die Wirtschaftsprüfung in den USA

Die jüngste politische Entwicklung in den Vereinigten Staaten lenkt das Augenmerk auf das Public Company Accounting Oversight Board (PCAOB), eine zentrale Institution, die für die Überwachung von Wirtschaftsprüfungen börsennotierter Unternehmen verantwortlich ist. Eine Gruppe republikanischer Gesetzgeber hat einen Vorschlag unterstützt, der die Auflösung des PCAOB vorsieht und die Zuständigkeiten an die Securities and Exchange Commission (SEC) übergibt.

Donald Trump betont Bedeutung von Kryptowährungen und will US-Vorsprung vor China sichern
Samstag, 14. November 2026. Donald Trump betont Bedeutung von Kryptowährungen und will US-Vorsprung vor China sichern

In einem kürzlich veröffentlichten Interview auf NBC News' „Meet the Press“ hat US-Präsident Donald Trump die bedeutende Rolle von Kryptowährungen in der globalen Finanzwelt hervorgehoben und seine Absicht deutlich gemacht, die USA als führende Nation im digitalen Asset-Bereich zu positionieren. Trump warnte, dass China, falls die USA nicht handeln, die Kontrolle über den Krypto-Sektor und andere aufstrebende Technologien übernehmen könnte.

Wie viele Chevron-Aktien braucht man, um 10.000 Dollar jährliche Dividenden zu erhalten?
Samstag, 14. November 2026. Wie viele Chevron-Aktien braucht man, um 10.000 Dollar jährliche Dividenden zu erhalten?

Die Suche nach verlässlichen Einkommensquellen aus Aktieninvestitionen führt viele Anleger zu Unternehmen mit stabilen und stetig steigenden Dividenden. Chevron, einer der größten Öl- und Gaskonzerne weltweit, gilt seit langem als attraktiv für Dividendeninvestoren.

Aurora Innovation, Inc. (AUR): Warum Insider und Leerverkäufer große Aktienpakete abstoßen
Samstag, 14. November 2026. Aurora Innovation, Inc. (AUR): Warum Insider und Leerverkäufer große Aktienpakete abstoßen

Aurora Innovation, Inc. (NASDAQ:AUR) ist momentan eine der bekanntesten amerikanischen Großunternehmen, die trotz ihrer starken Marktkapitalisierung von einem signifikanten Abverkauf durch Insider und Leerverkäufer betroffen ist.

Krypto-Markt im Fokus: SUI Explodiert um 8 % – Bitcoin Erholt sich nach Kursrutsch unter 94.000 US-Dollar
Samstag, 14. November 2026. Krypto-Markt im Fokus: SUI Explodiert um 8 % – Bitcoin Erholt sich nach Kursrutsch unter 94.000 US-Dollar

Der Kryptowährungsmarkt zeigt immer wieder seine Dynamik und unvorhersehbaren Wendungen. Aktuell rückt vor allem die Kryptowährung SUI in den Mittelpunkt des Interesses, nachdem sie mit einem beeindruckenden Kursanstieg von über 8 % zu den Top-Performern an den großen Kryptowährungsbörsen zählt.

Alcotraz: Das Gefängnis-Cocktail-Erlebnis der besonderen Art in Großbritannien
Samstag, 14. November 2026. Alcotraz: Das Gefängnis-Cocktail-Erlebnis der besonderen Art in Großbritannien

In einer Welt, in der gewöhnliche Bars und Cocktaillounges kaum noch überraschen, hat Alcotraz ein innovatives Konzept entwickelt, das barerlebnis und Unterhaltung auf eine völlig neue Ebene hebt. Alcotraz ist keine gewöhnliche Bar – es ist ein interaktives Theatererlebnis, das die Besucher in ein fesselndes, authentisches Gefängnisszenario versetzt.

Weitere Artikel zum Thema
Visa Revolutioniert den Zahlungsverkehr: Einführung einer Plattform für tokenisierte Fiat-Assets
Freitag, 13. November 2026. Visa Revolutioniert den Zahlungsverkehr: Einführung einer Plattform für tokenisierte Fiat-Assets

Visa präsentiert Plattform für tokenisierte Vermögenswerte: Ein neuer Schritt in die Zukunft der Fiat-unterstützten Tokens Die Welt der Finanztechnologie verändert sich rasant, und Unternehmen, die sich auf innovative Lösungen konzentrieren, nehmen eine führende Rolle in diesem Wandel ein. Visa, ein Gigant im Zahlungsverkehr, hat kürzlich die Einführung einer neuen Plattform für tokenisierte Vermögenswerte angekündigt, die speziell für Fiat-unterstützte Tokens entwickelt wurde.

Trump Media setzt Milliarden auf Bitcoin: Ein strategischer Schritt mit weitreichenden Konsequenzen
Samstag, 14. November 2026. Trump Media setzt Milliarden auf Bitcoin: Ein strategischer Schritt mit weitreichenden Konsequenzen

Die Trump Media & Technology Group (TMTG) hat kürzlich mit einer spektakulären Ankündigung für Aufsehen gesorgt, die nicht nur die Finanzwelt, sondern auch den Kryptomarkt in Atem hält. Das US-amerikanische Unternehmen, das vor allem durch seine Social-Media-Plattform Truth Social bekannt ist, plant ein gigantisches Investment in Bitcoin im Wert von 2,5 Milliarden US-Dollar.

Trump Tower Dubai: Luxuswohnungen im Wert von 1 Milliarde Dollar akzeptieren Kryptowährungen
Samstag, 14. November 2026. Trump Tower Dubai: Luxuswohnungen im Wert von 1 Milliarde Dollar akzeptieren Kryptowährungen

Das renommierte Trump-Imperium erweitert seine globale Präsenz erneut mit einem bahnbrechenden Immobilienprojekt in Dubai, das nicht nur durch seine architektonische Pracht, sondern auch durch seine innovative Zahlungsmethode Aufmerksamkeit erregt. Das Trump Tower Dubai, ein ambitioniertes Bauvorhaben mit einem Wert von rund einer Milliarde US-Dollar, wird künftig den Kauf von Luxuswohnungen mittels Kryptowährungen ermöglichen.

Trumps Exekutivbefehle und die Gründung der Kryptowährungs-Arbeitsgruppe: Ein Überblick
Freitag, 13. November 2026. Trumps Exekutivbefehle und die Gründung der Kryptowährungs-Arbeitsgruppe: Ein Überblick

Im Jahr 2023 wurden die Auswirkungen der Exekutivbefehle von Donald Trump auf die Welt der Kryptowährungen zunehmend klarer. Die Gründung der Kryptowährungs-Arbeitsgruppe steht im Mittelpunkt dieser Diskussion und hat enorme Bedeutung für die Regulierung und den Fortschritt digitaler Währungen in den USA und darüber hinaus.