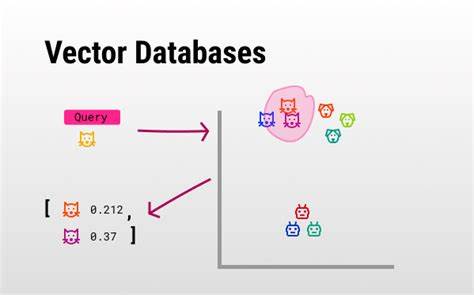
Vektordatenbanken gewinnen in Zeiten von Big Data, künstlicher Intelligenz und maschinellem Lernen zunehmend an Bedeutung. Sie ermöglichen es, umfangreiche Datenmengen anhand semantischer Ähnlichkeiten und komplexer Merkmale zu durchsuchen, und revolutionieren damit traditionelle Suchverfahren. Doch was verbirgt sich hinter einer Vektordatenbank, wie funktioniert sie und welche Technologien spielen dabei eine zentrale Rolle? In diesem Zusammenhang möchten wir einen praxisnahen Einblick in die Grundlagen und die Architektur geben, die nötig sind, um eine eigene Vektordatenbank zu entwickeln und zu verstehen. Vektoren und Vektorsuche bilden die Basis jeder Vektordatenbank. Ein Vektor ist vereinfacht ein Array mit numerischen Werten bestimmter Länge, die häufig als Dimensionen bezeichnet wird – etwa 768 oder 1024 Dimensionen.
Das Ziel einer Vektorsuche ist es, zu einem gegebenen Abfragevektor die k nächsten oder am besten passenden Vektoren aus einer riesigen Menge von möglichen Vektoren zu finden. Diese Vektoren stellen sogenannte Einbettungen oder Embeddings dar, die abstrakte Informationen in einem hochdimensionalen Raum kodieren. Beispielsweise kann ein Text, ein Bild oder auch ein anderes Objekt durch ein neuronales Netzwerk in eine numerische Repräsentation übersetzt werden, die ähnliche Bedeutungen oder Eigenschaften nahe zusammenfasst. Die Reise zur eigenen Vektordatenbank beginnt dabei oft mit der Herausforderung, wie man diese hochdimensionalen Daten effizient durchsuchen kann. Im Gegensatz zu klassischen Datenbanken, die strukturierte Datensätze und Schlüsselwerte managen, ist die Suche hier an das Finden von Nachbarn im Vektorraum gebunden. Einfach ausgedrückt: Wenn Sie ein bekanntes Objekt in Form eines Vektors haben, wie finden Sie die ähnlichsten oder relevantesten Objekte?
Erweiterte Algorithmen und Datenstrukturen helfen dabei, dieses Problem bei sehr großen Datenmengen performant zu lösen. Eine häufige Ausgangsidee ist die Verwendung einer räumlichen Unterteilung des Suchraums, ähnlich einem Gitter oder Raster, welches etwa auf geografischen Koordinaten basiert. Stellen Sie sich vor, Städte werden durch ihre Breitengrad- und Längengradkoordinaten auf einer Landkarte repräsentiert. In zwei Dimensionen ist es einfach, den Bereich zu unterteilen, beispielsweise in Quadranten oder Grid-Segmente. Doch schon bei einer Stadt wie New York zeigt sich, dass eine solche Unterteilung nicht ausreicht, um wirklich die nächsten Nachbarn schnell zu finden, da sich Millionen von Punkten in einem kleinen Gebiet ballen können. Je dichter die Datenpunkte, desto weniger sinnvoll ist eine starre Raumeinteilung.
Es ergibt sich das Problem, dass eine Suche immer größer werdende Gitterabschnitte durchsuchen muss, die ›nahe‹ liegen, aber dennoch nicht den nächsten Nachbarn darstellen. Bei höheren Dimensionen, also Vektoren mit mehreren Hundert oder Tausend Komponenten, verschärft sich die Situation drastisch. Die Flut an möglichen Kombinationen und Abständen führt dazu, dass gewohnte zweidimensionale Analogien schnell versagen und präzisere Methoden zum Einsatz kommen müssen. Ein Schlüssel zum effizienten Umgang mit hochdimensionalen Vektordaten liegt in der Berücksichtigung der tatsächlichen Datenverteilung. Die Sensitivität gegenüber Clustern, Dichten und Verteilungsmustern wird zum entscheidenden Faktor in der Gestaltung eines performanten Suchsystems. Eine Technik, die häufig angewandt wird, ist die sogenannte Quantisierung. Dabei werden die Originaldaten in einer Art komprimierter Form dargestellt, um Speicherbedarf und Rechenzeit zu reduzieren.
Technisch gesehen heißt das, dass exakte Werte wie 40,7128 beispielsweise auf 40,7 abgeschnitten werden können, um mit weniger Bits auszukommen. Allerdings führt eine simple Abschneidung oft zu Verlusten in der Genauigkeit. Fortgeschrittene Quantisierungsmethoden adaptieren diese Werte dynamisch, sodass Bereiche mit hoher Dichte (wie Ballungszentren) anders skaliert oder differenziert werden als dünn besiedelte Regionen (wie ländliche Gebiete). Das führt zu sogenannten Produktquantisierungen oder binären Quantisierungsmethoden, die ein ausgewogenes Verhältnis von Kompaktheit und Genauigkeit schaffen. Solche Techniken sorgen dafür, dass die Datenstruktur besser auf reale Verteilungen abgestimmt wird und eine effektivere Suche ermöglicht. Eng verbunden mit diesen Überlegungen ist das Konzept des Clusterns. Clusterbildung gruppiert ähnliche Vektoren oder Datenpunkte in „Nachbarschaften“ oder Zonen.
Ein populärer Algorithmus hierfür ist K-Means, der anfänglich eine bestimmte Anzahl (K) von Zentren definiert und diese solange verschiebt, bis die Summe der Abstände zu den Datenpunkten in einem Cluster minimal wird. Die Zentroiden fungieren so als Stellvertreter für große Datenbereiche, erlaubt im Vektorsuchkontext eine grobe Vorauswahl bei einem Query. Die Vorstellung dahinter ist, dass man anstatt Millionen oder Milliarden einzelner Vektoren zunächst nur eine sehr viel kleinere Menge von Clustern durchsucht. Anschließend erfolgt eine genauere Suche innerhalb des ausgewählten Clusters. Die Verwendung von Clustern erleichtert das Indexieren und macht Suchanfragen skalierbar bei enormen Datenmengen. Zahlreiche State-of-the-Art-Vektorsuchsysteme setzen Clustertechniken ein, um ihre Leistung bei Echtzeitanfragen zu garantieren.
Um jedoch maximale Genauigkeit und Schnelligkeit bei Suchanfragen in hochdimensionalen Räumen zu erzielen, kommen vermehrt graphbasierte Ansätze zum Tragen – allen voran die Methode der Hierarchical Navigable Small Worlds (HNSW). HNSW ist eine ausgeklügelte Graph-Datenstruktur, die Vektoren und deren Beziehungen untereinander abbildet. Die Besonderheit liegt darin, dass die Knoten (Vektoren) nicht einfach nur durch Kanten verbunden werden, sondern in hierarchischen Ebenen organisiert sind, um schnelle und gezielte Suchpfade zu ermöglichen. Das Prinzip erinnert an das Straßennetz in einer Großstadt mit verschiedenen Ebenen von Straßen: kleine Gassen, Hauptstraßen und Autobahnen. Um effizient von einem Punkt zum anderen zu gelangen, würde man zuerst große Straßen benutzen und sich dann in die kleineren Straßen hineinarbeiten. Genauso nutzt HNSW eine Hierarchie von Graphenebenen, um erst grob und dann exakt die gesuchten Nachbarn zu finden.
Jeder Vektor ist auf mehreren Ebenen vertreten und mit einer begrenzten Anzahl von „Nachbarn“ verbunden, was eine sehr skalierbare Navigation erlaubt. Der einfache Aufbau eines solchen Graphen basiert auf Knoten, welche die Vektoren und deren Identitäten speichern. Jeder Knoten hält eine Liste von Nachbarelementen – also direkte Verbindungen zu anderen Knoten in seinem Netzwerk. Die Suche beginnt an einem definierten Einstiegspunkt und folgt iterativ den Nachbarn, die dem gesuchten Vektor am nächsten sind. Dabei werden besuchte Knoten getrackt, um Schleifen zu vermeiden. In der Praxis wird bei jeder Iteration geprüft, ob es besser geeignete Nachbarn gibt, bis der Algorithmus nicht mehr näher an den Zielvektor kommt. So gelingt eine effiziente Annäherung an den besten Treffer, ohne jeden einzelnen Knoten prüfen zu müssen. Ein solcher Suchlauf in einem hierarchischen Navigierbaren Graphen ist nicht nur schnell, sondern auch äußerst präzise.
Die Verbindung von Knoten ist dabei subtil geregelt über Parameter wie M und ef. M bestimmt, wie viele Verbindungen (Nachbarn) ein Knoten maximal haben darf. Je höher M ist, desto dichter wird das Graphnetz, was zu präziseren Suchergebnissen führt, aber die Einfügeoperationen aufwendiger macht. Der Parameter ef stellt ein Maß für die „Tiefe“ der Suchpfade dar – wie viele Wege parallel verfolgt werden, bevor eine finale Entscheidung getroffen wird. Diese beiden hyperparametrischen Einstellungen müssen je nach Anwendungsfall feinjustiert werden, um Balance zwischen Suchgeschwindigkeit und Treffergenauigkeit zu wirken. Eine weitere Herausforderung, die mit HNSW einhergeht, ist die Schaffung der Hierarchie. Wird keine Hierarchie aufgebaut, ähnelt die Struktur einem flachen Dorfstraßennetz, bei dem jeder Knoten nur lokale Verbindungen besitzt.
Um große Distanzen im Graphen effizient zu überwinden, benötigen wir übergeordnete Ebenen, die punktuelle Sprünge über größere Gruppen von Knoten erlauben. Diese hierarchische Struktur schützt den Suchprozess davor, in lokalen Minima stecken zu bleiben und beschleunigt die Navigation enorm. Zusammenfassend lässt sich sagen, dass der Aufbau einer eigenen Vektordatenbank mit HNSW ein faszinierendes Zusammenspiel von Algorithmen, Datenstrukturen und Optimierungsparametern verlangt. Angefangen bei der richtigen Einbettung der Daten als Vektoren, über kluge Partitionierungs- und Clusteringstrategien, bis hin zur Implementierung eines durchdachten graphbasierten Navigationssystems. Die Entwicklung einer solchen Lösung erfordert ein tiefes Verständnis der mathematischen Grundlagen, aber auch praktische Erfahrungen im Umgang mit großen Datensätzen und der Feinabstimmung von Suchparametern unter realen Bedingungen.
Für Entwickler und Unternehmen, die semantische Suche oder Ähnlichkeitssuche auf Basis von Vektordaten anbieten wollen, ist der Einsatz von HNSW mittlerweile Standard, um schnelle, skalierbare und genaue Resultate zu erzielen. Wer das Thema weiter vertiefen möchte, sollte sich mit den Grundlagen von Vektorraum-Modellen, der Theorie der kleinweltnetzartigen Graphen und modernen Verfahren der Produktquantisierung vertraut machen. Zusätzlich hat sich die Kombination von Vektordatenbanken mit großen Sprachmodellen (LLMs) als besonders wirkungsvoll erwiesen, um komplexe Suchanfragen in natürlicher Sprache zu verarbeiten. Auf dem Weg zur eigenen Vektordatenbank bieten HNSW und verwandte Techniken eine robuste Basis, um anspruchsvolle semantische Suchlösungen zu konstruieren.
Die richtige Architektur ermöglicht es, inmitten großer, komplexer Datenwelten zielgerichtet die tatsächlich relevanten Informationen zu finden – und damit den digitalen Wandel in verschiedensten Branchen entscheidend mitzugestalten.