NFT Digital Art DeFi

Verstehen große Sprachmodelle wirklich, wer was wem getan hat? Eine tiefgehende Analyse

Eine umfassende Untersuchung darüber, wie große Sprachmodelle thematische Rollen in Sätzen erkennen und verarbeiten, und welche Implikationen dies für das Verständnis von KI und Sprachverarbeitung hat.

Verstehen große Sprachmodelle wirklich, wer was wem getan hat? Eine tiefgehende Analyse

Die rasante Entwicklung großer Sprachmodelle (Large Language Models, LLMs) hat in den letzten Jahren einen gewaltigen Fortschritt in der natürlichen Sprachverarbeitung ermöglicht. Diese Modelle, zu denen beispielsweise GPT-3, LLaMA oder PaLM gehören, können inzwischen Texte generieren, Fragen beantworten und sogar komplexe Dialoge führen, die teilweise verblüffend menschlich wirken. Dennoch stellt sich die fundamentale Frage, ob diese KI-Systeme wirklich verstehen, was in einem Satz passiert, insbesondere wenn es darum geht, wer welche Handlung an wem ausführt – also die sogenannten thematischen Rollen. Dieses Problem wird oft verkürzt mit der Frage umschrieben: Wissen große Sprachmodelle, wer was wem getan hat? Der Ursprung dieser Fragestellung liegt in der linguistischen Semantik und Pragmatik, wo die Bestimmung von Akteur (Agent) und Empfänger einer Handlung (Patient) zentral für das Verstehen eines Satzes ist.

Beispielsweise enthält der Satz „Der Hund beißt den Mann“ eine klare Rollenverteilung: Der Hund ist der Akteur, der beißt, und der Mann ist derjenige, dem etwas widerfährt. Für Menschen sind diese Rollen intuitiv und unmittelbar erfassbar, doch wie sieht es bei LLMs aus? Neuere wissenschaftliche Untersuchungen, wie die von Joseph M. Denning und Kollegen, haben sich genau mit diesem Aspekt auseinandergesetzt. Ihre Studien konzentrieren sich auf die innere Repräsentation von thematischen Rollen in den neuronalen Netzen und analysieren, in welchem Maße Sprachmodelle die Unterschiede in der semantischen Bedeutung von Sätzen wirklich erfassen. Dabei wird deutlich, dass der herkömmliche Trainingsansatz, der auf Wortvorhersage basiert, nicht zwangsläufig dazu führt, dass ein Modell tiefgehende Wissensstrukturen zu Handlungsszenarien entwickelt.

Die Forscher haben verschiedene große Sprachmodelle untersucht und dabei herausgefunden, dass die generelle Ähnlichkeit zwischen Satzpaaren im Modell eher durch syntaktische Strukturen als durch die Zuordnung von Akteuren und Patienten bestimmt wird. Das bedeutet, dass Sätze mit identischem Satzbau im Modell als ähnlicher empfunden werden, selbst wenn die Rollen vertauscht sind, also wer Täter und wer Opfer ist. Für Menschen dagegen ist die Umkehrung der Rollen eine tiefgreifende Bedeutungsänderung, die im Modell nur schwach abgebildet wird. Ein weiterer interessanter Befund betrifft die Aufteilung innerhalb des Modells: Während die Gesamtrepräsentation nur geringe Hinweise auf das Verständnis von thematischen Rollen zeigt, konnten einzelne Aufmerksamkeitsmechanismen (Attention Heads) in den Transformermodellen spezifische Informationen zu diesen Rollen recht robust extrahieren.

Diese Aufmerksamkeitseinheiten scheinen sich auf die Beziehung zwischen Agent und Patient zu konzentrieren, unabhängig von der syntaktischen Struktur des Satzes. Daraus lässt sich ablesen, dass große Sprachmodelle das Potenzial haben, solche semantischen Rollen zu lernen und zu repräsentieren, sie aber nicht in der Gesamtheit ihres Wissensstands dominant werden. Dies wirft wichtige Fragen für die zukünftige Entwicklung von Sprach-KI auf. Einerseits kann man argumentieren, dass LLMs in ihrer jetzigen Form keine echte semantische Repräsentation besitzen und somit tiefergehendes Textverständnis fehlt. Andererseits zeigen die Ergebnisse, dass das „Verständnis“ in gewisser Weise modular ist, wobei spezialisierte Einheiten im Netzwerk solche Informationen verarbeiten, auch wenn sie nicht das dominante Signal im Gesamtsystem sind. Warum ist diese Erkenntnis relevant?

In zahlreichen Anwendungen, von automatisierten Übersetzungen über Textzusammenfassungen bis hin zu Chatbots oder virtuellen Assistenten, ist das korrekte Erfassen der Beteiligten an einem Handlungsverlauf essenziell. Wenn ein System nicht zuverlässig erkennt, wer im Text handelt und wer betroffen ist, kann dies zu Missverständnissen und fehlerhaften Reaktionen führen. Dies zeigt, dass trotz beeindruckender Leistungen der aktuellen Modelle weiterhin fundamentale Herausforderungen bestehen, wenn es um tieferes Sprachverständnis geht. Ein möglicher Weg, um die Repräsentation von thematischen Rollen zu verbessern, könnte in einer gezielteren Datenaufbereitung liegen. Trainingsdaten, die explizit auf Rollenzuweisung und semantische Beziehungen fokussieren, könnten Modelle besser darin schulen, solche Informationen zu erfassen und zu nutzen. Auch die Entwicklung neuer Modellarchitekturen oder zusätzlicher Lernziele neben der bloßen Wortvorhersage könnten hier eine Rolle spielen.

Aus linguistischer Sicht ist der Umgang mit thematischen Rollen eng mit dem Verständnis von Syntax, Semantik und Pragmatik verknüpft. Große Sprachmodelle zeigen bisher vor allem eine starke Orientierung an syntaktischen Mustern, was erklärt, warum sie bei Rollenvertauschungen Schwierigkeiten haben. Es bedarf also weiterer Forschung, um besser zu verstehen, wie diese Ebenen zusammenspielen und wie KI-Systeme dazu gebracht werden können, ein menschennahes Verständnis von Handlungskonstellationen zu entwickeln. Schließlich hat die Frage, ob große Sprachmodelle wissen, wer was wem getan hat, auch eine philosophische Dimension. Versteht eine Maschine wirklich, was sie „liest“ oder „schreibt“, oder basiert alles nur auf statistischer Mustererkennung? Die neueren Studien legen nahe, dass das Verständnis zumindest in der heutigen Form von LLMs eher partiell und begrenzt ist.

Das bedeutet allerdings nicht, dass kein Fortschritt möglich ist – vielmehr zeigt sich ein dezidiertes Potenzial innerhalb der Modelle, das mit gezielter Weiterentwicklung, besseren Trainingsdaten und neuen Lernmethoden voll ausgeschöpft werden kann. Insgesamt lässt sich zusammenfassen, dass großskalige Sprachmodelle zwar grundsätzlich die Fähigkeit haben, thematische Rollen aus Texten zu extrahieren, diese Fähigkeit aber in der aktuellen Modellgeneration relativ schwach ausgeprägt und im Gesamtrepräsentationsraum nicht klar dominant ist. Das eröffnet spannende Perspektiven für künftige Forschung und Entwicklung im Bereich der künstlichen Intelligenz und Sprachverarbeitung, um die nächste Generation von Modellen noch besser und menschenähnlicher im Sprachverständnis zu machen.

OKX Partnerinhalte

Registrieren Sie sich bei OKX und erhalten Sie Ihren Willkommensbonus

OKX ist eine Plattform für Spot- und Futures-Handel, P2P-Tausch und Krypto-Sparpläne. Ein neues Konto über diesen Link eröffnet Zugang zum Willkommensbonus-Programm: bis zu 10.000 USDT für Ihre ersten Schritte an der Börse.

Konto erstellen und Bonus erhalten →

18+ · Partnerlink. Kryptowährungen sind volatil: Sie können Ihre Einlage verlieren.

Als Nächstes
Elon Musk und das Aus für das DOE-Darlehensbüro: Ein Rückschlag für die amerikanische Energiewende?
Freitag, 13. November 2026. Elon Musk und das Aus für das DOE-Darlehensbüro: Ein Rückschlag für die amerikanische Energiewende?

Elon Musk ist heutzutage synonym mit Innovation, Elektroautos und visionärem Unternehmertum. Als Gründer und Kopf von Tesla hat er die Automobilindustrie revolutioniert und einen großen Beitrag zur weltweiten Akzeptanz von Elektrofahrzeugen geleistet.

Ehemaliger Disney-Mitarbeiter wegen Hackerangriffs auf Disney World-Menüs zu drei Jahren Haft verurteilt
Freitag, 13. November 2026. Ehemaliger Disney-Mitarbeiter wegen Hackerangriffs auf Disney World-Menüs zu drei Jahren Haft verurteilt

Im April 2025 wurde Michael Scheuer, ein ehemaliger Mitarbeiter von Disney World, zu drei Jahren Bundeshaft verurteilt, nachdem er illegale Manipulationen an den digitalen Menüs von Disney World-Restaurants vorgenommen hatte. Seine kriminelle Handlung sorgte nicht nur für Schlagzeilen, sondern wirft auch ein Schlaglicht auf die Herausforderungen der Cybersicherheit in großen Unternehmen und Freizeitparks.

Die faszinierende Geschichte und Bedeutung der TUT-Sprache: Ein verborgenes Erbe afroamerikanischer Kultur
Freitag, 13. November 2026. Die faszinierende Geschichte und Bedeutung der TUT-Sprache: Ein verborgenes Erbe afroamerikanischer Kultur

Die TUT-Sprache ist weit mehr als nur eine geheimnisvolle Code-Sprache; sie umfasst eine tief verwurzelte kulturelle Geschichte, die in der Zeit der amerikanischen Sklaverei entstanden ist. In einer Epoche, in der afroamerikanische Sklaven maximaler Unterdrückung und Repression ausgesetzt waren, entwickelte sich diese besondere Sprachform als ein Mittel zur Kommunikation und zum Erlernen von Wissen, um der verboten geglaubten Bildung und dem damit verbundenen Aufstieg entgegenzuwirken.

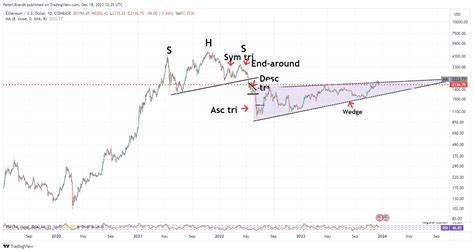
Ethereum vor großem Absturz? Veteranenhändler Peter Brandt warnt vor einem Kursverfall auf 800 US-Dollar
Freitag, 13. November 2026. Ethereum vor großem Absturz? Veteranenhändler Peter Brandt warnt vor einem Kursverfall auf 800 US-Dollar

Ethereum, die zweitgrößte Kryptowährung nach Marktkapitalisierung, steht erneut im Fokus der Finanzwelt – diesmal jedoch mit einer düsteren Prognose, die unter Krypto-Enthusiasten und Investoren für Aufsehen sorgt. Der erfahrene Trader und Marktanalyst Peter Brandt, der in beiden Welten – traditionellen Rohstoffmärkten und Kryptowährungen – einen exzellenten Ruf genießt, hat öffentlich seine Bedenken geäußert, dass Ethereum auf rund 800 US-Dollar fallen könnte.

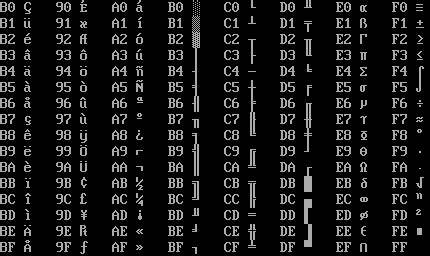
Das IBM PC Technical Reference Character Set (00-FF) – Ein Überblick über Code Page 437 und seine historische Bedeutung
Freitag, 13. November 2026. Das IBM PC Technical Reference Character Set (00-FF) – Ein Überblick über Code Page 437 und seine historische Bedeutung

In der Geschichte der Personal Computer spielt das IBM PC Technical Reference Character Set (00-FF), auch bekannt als Code Page 437, eine bedeutende Rolle. Es handelt sich dabei um die originale Zeichentabelle, die im IBM PC Modell 5150 verwendet wurde und somit die Grundlage für viele frühe grafische Benutzeroberflächen und Textdarstellungen bildete.

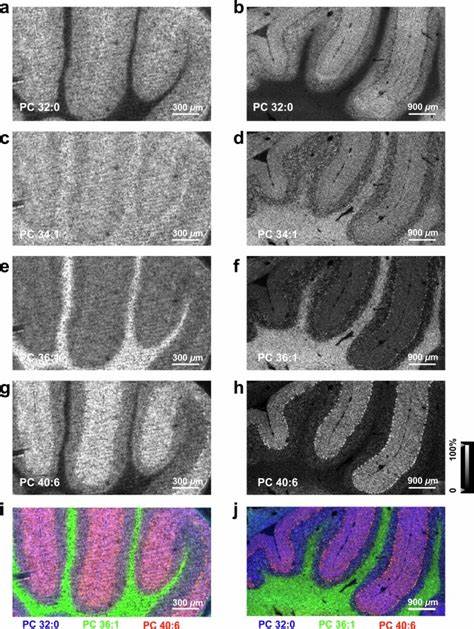
TEMI – Revolutionäre Gewebeexpansion für hochauflösende Massenspektrometrie-Bildgebung
Freitag, 13. November 2026. TEMI – Revolutionäre Gewebeexpansion für hochauflösende Massenspektrometrie-Bildgebung

Die Erforschung der molekularen Zusammensetzung von Geweben ist essenziell, um biologische Prozesse und Erkrankungen umfassend zu verstehen. Dabei spielt die räumliche Verteilung verschiedener Biomoleküle wie Lipide, Metabolite, Proteine und komplexe Zuckerstrukturen eine entscheidende Rolle für physiologische Funktionen oder Pathologien.

Verfassung und rechtliches Gehör für illegale Einwanderer: Eine umfassende Betrachtung
Freitag, 13. November 2026. Verfassung und rechtliches Gehör für illegale Einwanderer: Eine umfassende Betrachtung

Die Frage nach den verfassungsmäßigen Rechten und dem Zugang zum rechtlichen Gehör für Menschen, die ohne gültigen Aufenthaltstitel in ein Land eingereist sind, ist komplex und von großer gesellschaftlicher Relevanz. Dabei sind insbesondere zwei zentrale Aspekte zu beleuchten: Welche Rechte genießen illegale Einwanderer nach den jeweiligen Verfassungen und welche Verfahren müssen eingehalten werden, um ihren Anspruch auf rechtliches Gehör und faire Verfahren zu gewährleisten.

Weitere Artikel zum Thema
Die faszinierende Genealogie von Papst Leo XIV: Eine Reise durch Kulturen und Jahrhunderte
Samstag, 14. November 2026. Die faszinierende Genealogie von Papst Leo XIV: Eine Reise durch Kulturen und Jahrhunderte

Papst Leo XIV, bekannt als Robert Francis Prevost, ist eine Persönlichkeit, deren Herkunft mehr ist als nur ein genealogisches Rätsel – sie ist ein Spiegelbild der einzigartigen und vielfältigen Geschichte Amerikas und der Neuen Welt. Seine familiären Wurzeln reichen mehrere Jahrhunderte zurück und verbinden unter anderem spanische Edelpersonen, italienische Immigranten, französisch-kanadische Siedler sowie afro-amerikanische Vorfahren.

Bitcoin Angebotsverknappung: Wie „uralte“ Halter die frisch geschürften BTC übertreffen
Samstag, 14. November 2026. Bitcoin Angebotsverknappung: Wie „uralte“ Halter die frisch geschürften BTC übertreffen

Der Bitcoin-Markt befindet sich in einer fundamentalen Umbruchphase, getrieben von einer bemerkenswerten Entwicklung in der Angebotsseite der Kryptowährung. Der Anteil der sogenannten „uralten“ Bitcoin-Halter – jene, die ihre Coins seit mehr als zehn Jahren besitzen – wächst in einem Tempo, das die Anzahl der täglich neu geschürften Bitcoins übertrifft.

Rostin Behnam: CFTC-Vorsitzender erklärt nur Bitcoin als Ware – Ethereum bleibt außen vor
Freitag, 13. November 2026. Rostin Behnam: CFTC-Vorsitzender erklärt nur Bitcoin als Ware – Ethereum bleibt außen vor

In einer kürzlich veröffentlichten Stellungnahme sorgte Rostin Behnam, der Vorsitzende der Commodity Futures Trading Commission (CFTC), für Aufsehen, als er erklärte, dass nur Bitcoin als Rohstoff anerkannt werden könne, während Ethereum und andere Kryptowährungen nicht in dieselbe Kategorie fallen. Diese Aussage wirft Fragen auf und spiegelt die anhaltende Debatte über die Regulierung von Kryptowährungen wider, die in den letzten Jahren immer lauter geworden ist.

Kryptowährungen im Glücksspielmodus: Wie Memecoin-Erwähnungen ein Jahreshoch erreichen und den Markt prägen
Samstag, 14. November 2026. Kryptowährungen im Glücksspielmodus: Wie Memecoin-Erwähnungen ein Jahreshoch erreichen und den Markt prägen

Der Kryptomarkt erlebt eine bemerkenswerte Verschiebung der Anlegermentalität hin zu einem risikofreudigeren, fast spielerischen Umgang mit digitalen Vermögenswerten. Wie aktuelle Analysen von Santiment zeigen, haben sich die Online-Diskussionen rund um Memecoins im Jahr 2025 auf ein neues Hoch gesteigert, was die intensive Begeisterung und das gesteigerte Interesse an diesen hochspekulativen Token verdeutlicht.