Analyse des Kryptomarktes Stallmünzen Interviews mit Branchenführern

Direct Preference Optimization vs. RLHF: Revolutionäre Methoden zur Sprachmodell-Optimierung im Vergleich

Ein umfassender Überblick über Direct Preference Optimization (DPO) und Reinforcement Learning from Human Feedback (RLHF) als moderne Techniken der Feinabstimmung großer Sprachmodelle. Erläutert werden Funktionsweisen, Vorteile, Anwendungsbereiche sowie praktische Empfehlungen für Entwickler und Unternehmen, die KI-Systeme an menschliche Präferenzen angleichen möchten.

Direct Preference Optimization vs. RLHF: Revolutionäre Methoden zur Sprachmodell-Optimierung im Vergleich

Die rasante Entwicklung von großen Sprachmodellen in den letzten Jahren hat die Art und Weise revolutioniert, wie Künstliche Intelligenz (KI) mit Menschen interagiert. Doch um diese Modelle wirklich nutzerzentriert, hilfreich und zuverlässig zu machen, reicht es nicht aus, sie nur mit Standarddaten zu trainieren. Es bedarf gezielter Techniken, die Sprachmodelle anhand menschlicher Vorlieben optimieren. Hier stoßen zwei Ansätze in den Fokus: Direct Preference Optimization (DPO) und Reinforcement Learning from Human Feedback (RLHF). Beide zielen darauf ab, KI-Modelle so zu trainieren, dass sie Antworten generieren, die für Nutzer nicht nur korrekt, sondern auch angenehm und sinnvoll im Kontext sind. Dennoch unterscheiden sie sich grundlegend in ihrer Methodik und Komplexität. Direkt Preference Optimization, kurz DPO, setzt auf eine direkte Anpassung des Modells anhand von Vergleichsdaten menschlicher Präferenzen ohne den Einsatz komplexer Verstärkungslernverfahren.

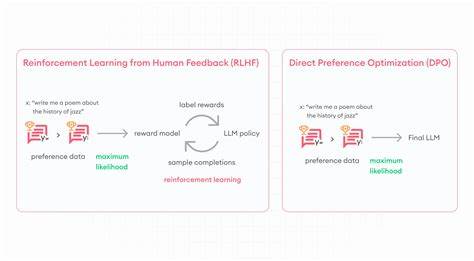
Anders als bei RLHF, das einen mehrstufigen Prozess mit der Erstellung und Optimierung eines sogenannten Reward Modells erfordert, basiert DPO auf einfachen Verlustfunktionen, die die Wahrscheinlichkeit bevorzugter Antworten erhöhen und die von abgelehnten verringern. Dadurch wird der Trainingsprozess vereinfacht, ressourcenschonender und schneller, was besonders für Entwickler und Unternehmen interessant ist, die eine effiziente und schlanke Pipeline bevorzugen. Ein anschauliches Bild für DPO ist das Kochen mit einem Rezeptbuch. Anstatt einen Food-Kritiker zu engagieren und wiederholt neue Gerichte zu testen, passt der Koch direkt seine Rezepte an, indem er Kundenfeedback nutzt. Dabei sorgt ein spezieller Parameter, β genannt, dafür, dass das Modell sich kontrolliert verändert und nicht zu stark von bewährten Grundlagen abweicht. Die Einstellung dieses Parameters erlaubt eine Balance zwischen Innovation und Stabilität.

Reinforcement Learning from Human Feedback hat sich in der Sprachmodellforschung als traditionelle Methode zur Modellanpassung etabliert. Die Vorgehensweise sieht vor, zunächst ein Reward Modell zu trainieren, das auf Basis menschlicher Bewertungen bestimmt, wie gut bestimmte Ausgaben des Sprachmodells sind. Anschließend erfolgt das Reinforcement Learning, häufig mit der Proximal Policy Optimization (PPO), das die Sprachmodell-Policy gegenüber diesem Reward Modell optimiert. Diese Methode ist zwar effektiv, bringt aber eine erhöhte Komplexität mit sich, insbesondere in der Modellarchitektur und im Trainingsmanagement. Zudem erzeugt RLHF oft eine größere Rechenlast, da während des Trainings kontinuierlich online Daten zur Modellbewertung generiert werden müssen. Hinsichtlich der Ergebnisse zeigen Studien, dass DPO in vielen Fällen die Leistungsfähigkeit von RLHF erreichen oder sogar übertreffen kann, ohne deren komplexen Aufbau.

Beide Methoden fördern die hilfreiche und präzise Beantwortung von Nutzerfragen, verbessern den Tonfall und fördern die Wahrhaftigkeit sowie die Schadlosigkeit der Antworten. Besondere Stärken von DPO liegen in vielfältigen Anwendungsfällen, in denen es mehrere valide Antwortmöglichkeiten gibt und das Urteil über deren Qualität subtil und kontextabhängig ist. Beispiele sind Chatbots in spezialisierten Bereichen wie Medizin oder Psychologie, wo eine exakte, aber auch einfühlsame Kommunikation entscheidend ist, sowie bei der Zusammenfassung von Texten, der Code-Generierung und der Schreibassistenz. DPO nutzt die Tatsache, dass es für Menschen oft einfacher ist, zwei Alternativen zu bewerten, als perfekte Antworten zu formulieren. Das macht das Sammeln und Verarbeiten von Trainingsdaten effizienter und ermöglicht gezieltere Verbesserungen bestehender Modelle durch eine feinere Abstimmung. Natürlich ist DPO nicht für alle Aufgaben gleichermaßen geeignet.

Für Szenarien mit eindeutig richtigen Antworten, wie bei der Informationsentnahme, Klassifikation oder mathematischen Berechnungen, bietet der Ansatz keine Vorteile gegenüber klassischen Methoden. Dort ist oft eine direkte, regelbasierte Anpassung oder andere Trainingsverfahren zielführender. Ein pragmatischer Trainingsansatz kombiniert die Vorteile von Supervised Fine-Tuning (SFT) mit DPO. In einem ersten Schritt lernt das Modell mit SFT die Grundlagen einer Aufgabe und die gewünschte Antwortstruktur. Anschließend erfolgt das weiterführende Feintuning mit DPO, wobei der Fokus auf der Optimierung der Präferenzorientierung liegt. Diese zweistufige Strategie stellt sicher, dass das Modell nicht nur die Grundlagen beherrscht, sondern auch feine Nuancen menschlicher Präferenzen zuverlässig umsetzen kann.

Für Entwickler ist es hilfreich, den Einfluss des β-Parameters bei DPO zu beachten, der steuert, wie stark das Modell beim Lernen neuer Präferenzen von seinem Ursprungszustand abweichen darf. Die Anpassung dieses Wertes beeinflusst die Geschwindigkeit und das Ausmaß der Verbesserungen. Außerdem ermöglichen spezifische Metriken wie Genauigkeit der Präferenzunterscheidung und die Berechnung der KL-Divergenz zwischen dem angepassten und ursprünglichen Modell eine gezielte Überwachung des Trainingsfortschritts. Insgesamt bietet die Wahl zwischen DPO und RLHF je nach Projektziel und verfügbaren Ressourcen unterschiedliche Vorzüge. Wer ein robustes, weniger komplexes und schneller implementierbares System sucht, das auf detaillierten menschlichen Präferenzen basiert, findet in DPO eine moderne und überzeugende Alternative.

Soll dagegen ein besonders entwickeltes Reward Modell mit stetiger Rückkopplung und Potenzial zur dauerhaften Policy-Optimierung gewünscht wird, kann RLHF trotz seiner Komplexität die bessere Wahl sein. Die Zukunft der Sprachmodell-Anpassung dürfte eine Mischung aus beiden Welten darstellen, unterstützt durch stetige Fortschritte in Rechenleistung und Datensammlung. Letztlich gewinnen Unternehmen und Entwickler durch ein tieferes Verständnis der Mechanismen hinter DPO und RLHF die Möglichkeit, KI-Systeme zielgenau und effizienter als je zuvor an die Erwartungen und Bedürfnisse der Nutzer anzupassen. Damit wird nicht nur die Nutzererfahrung verbessert, sondern auch das Vertrauen in KI-Anwendungen nachhaltig gestärkt.
OKX Partnerinhalte

Registrieren Sie sich bei OKX und erhalten Sie Ihren Willkommensbonus

OKX ist eine Plattform für Spot- und Futures-Handel, P2P-Tausch und Krypto-Sparpläne. Ein neues Konto über diesen Link eröffnet Zugang zum Willkommensbonus-Programm: bis zu 10.000 USDT für Ihre ersten Schritte an der Börse.

Konto erstellen und Bonus erhalten →

18+ · Partnerlink. Kryptowährungen sind volatil: Sie können Ihre Einlage verlieren.

Als Nächstes
Remixpoint investiert weitere 7 Millionen Dollar in Bitcoin und erhöht Gesamtbestand auf 84 Millionen Dollar
Samstag, 14. November 2026. Remixpoint investiert weitere 7 Millionen Dollar in Bitcoin und erhöht Gesamtbestand auf 84 Millionen Dollar

Das japanische Unternehmen Remixpoint hat kürzlich bekannt gegeben, dass es Bitcoin im Wert von sieben Millionen US-Dollar erworben hat. Dies steigert die gesamten Krypto-Bestände des Unternehmens auf etwa 84 Millionen US-Dollar.

Trauminhalte entdecken: Wie Künstliche Intelligenz und Social Media die Traumforschung revolutionieren
Samstag, 14. November 2026. Trauminhalte entdecken: Wie Künstliche Intelligenz und Social Media die Traumforschung revolutionieren

Träume sind seit jeher ein faszinierendes und mysteriöses Phänomen, das Wissenschaftler, Psychologen und Laien gleichermaßen interessiert. Sie sind ein Spiegel unserer Psyche, unserer Erlebnisse und unserer Ängste, doch gleichzeitig bleiben viele Aspekte des Träumens rätselhaft und wenig erforscht.

Wall Street im Sturzflug: Die Rückkehr der Angst vor dem US-China-Handelskrieg und deren Auswirkungen auf die Aktienmärkte
Samstag, 14. November 2026. Wall Street im Sturzflug: Die Rückkehr der Angst vor dem US-China-Handelskrieg und deren Auswirkungen auf die Aktienmärkte

Die Aktienmärkte in den Vereinigten Staaten durchleben derzeit eine Phase dramatischer Schwankungen, die von anfänglicher Euphorie zu tiefgreifender Sorge über einen eskalierenden Handelskrieg zwischen den USA und China umschlagen. Der plötzliche Einbruch an der Wall Street hat viele Marktteilnehmer überrascht und zeigt eindringlich, wie sensibel die globalen Finanzmärkte auf geopolitische Konflikte reagieren.

Iraq und Geo-Jade schließen wegweisenden integrierten Energievertrag für nachhaltige Entwicklung
Samstag, 14. November 2026. Iraq und Geo-Jade schließen wegweisenden integrierten Energievertrag für nachhaltige Entwicklung

Iraq befindet sich aktuell auf einem entscheidenden Weg, um seine Energieinfrastruktur umfassend zu modernisieren und die Bedeutung der internationalen Zusammenarbeit in diesem Sektor zu stärken. Ein bemerkenswertes Beispiel hierfür ist der kürzlich unterzeichnete integrierte Energievertrag mit der chinesischen Geo-Jade Petroleum sowie dem lokalen Unternehmen Basra Crescent.

Die Kryptowährung mit dem höchsten Wachstumspotenzial: Cathie Woods Prognose für Bitcoin bis 2030
Samstag, 14. November 2026. Die Kryptowährung mit dem höchsten Wachstumspotenzial: Cathie Woods Prognose für Bitcoin bis 2030

Die Welt der Kryptowährungen fasziniert Anleger und Technikbegeisterte gleichermaßen. Unter den zahlreichen digitalen Assets steht Bitcoin weiterhin im Rampenlicht und gilt als die Ur-Kryptowährung mit dem größten Einfluss auf den Markt.

Wie reale Kartendaten die Zukunft von Farming- und Transportspielen revolutionieren
Samstag, 14. November 2026. Wie reale Kartendaten die Zukunft von Farming- und Transportspielen revolutionieren

In der Welt der Computerspiele gewinnen Management-Simulationen, die sich mit Themen wie Landwirtschaft und öffentlichem Nahverkehr beschäftigen, zunehmend an Bedeutung. Insbesondere Spiele wie City Bus Manager und Global Farmer setzen dabei auf reale Kartendaten, um ein authentisches und nachvollziehbares Spielerlebnis zu schaffen.

Ondo Finance beschleunigt Krypto-Transaktionen mit BlackRocks tokenisiertem Fonds BUIDL
Samstag, 14. November 2026. Ondo Finance beschleunigt Krypto-Transaktionen mit BlackRocks tokenisiertem Fonds BUIDL

Die Verschmelzung von traditionellen Finanzmärkten mit der Kryptoökonomie schreitet immer schneller voran. Ein bedeutender Meilenstein in dieser Entwicklung ist die Entscheidung von Ondo Finance, 95 Millionen US-Dollar in BlackRocks tokenisierten Fonds BUIDL zu verlagern.

Weitere Artikel zum Thema
Tether prägt 19 Milliarden USDT in einem Monat – Was bedeutet das für den Kryptomarkt?
Samstag, 14. November 2026. Tether prägt 19 Milliarden USDT in einem Monat – Was bedeutet das für den Kryptomarkt?

In der dynamischen Landschaft der Kryptowährungen sorgt die Ankündigung von Tether, innerhalb eines Monats 19 Milliarden USDT (Tether-Dollar) geprägt zu haben, für erhebliches Aufsehen und Besorgnis. Tether ist eine der größten Stablecoins weltweit und dient als digitale Alternative zum US-Dollar, die von vielen Tradern und Investoren als stabiles Wertaufbewahrungsmittel genutzt wird.

Solana Launchpad Pump.fun: Klage wegen Missbrauchs von Nutzern mit umstrittenem Inhalt
Freitag, 13. November 2026. Solana Launchpad Pump.fun: Klage wegen Missbrauchs von Nutzern mit umstrittenem Inhalt

Die Welt der Kryptowährungen und Blockchain-Technologie hat in den letzten Jahren ein rapide Wachstum erlebt. Mit dieser Expansion kamen jedoch auch Herausforderungen und Kontroversen, die das Vertrauen der Nutzer beeinflussen können.

Bitcoin-Preis erreicht 99,5K USD nach Rekordabfluss von Bitcoin-ETFs
Freitag, 13. November 2026. Bitcoin-Preis erreicht 99,5K USD nach Rekordabfluss von Bitcoin-ETFs

In der aufregenden Welt der Kryptowährungen ist es nicht ungewöhnlich, dass sich die Märkte schnell bewegen, aber der jüngste Anstieg des Bitcoin-Preises auf bemerkenswerte 99,5K USD innerhalb von Stunden nach einem Rekordabfluss aus Bitcoin-ETFs hat die Aufmerksamkeit von Anlegern und Analysten gleichermaßen auf sich gezogen. In diesem Artikel untersuchen wir die Hintergründe dieses bemerkenswerten Preisanstiegs und die möglichen Auswirkungen auf den Markt.

Immaculata.dev: Revolutionäre Node.js-Hilfsmittel für die Frontend-Entwicklung
Samstag, 14. November 2026. Immaculata.dev: Revolutionäre Node.js-Hilfsmittel für die Frontend-Entwicklung

Die Entwicklung von modernen Frontend-Webseiten erfordert zunehmend leistungsstarke Werkzeuge, die den komplexen Anforderungen heutiger Webprojekte gerecht werden. Immaculata.