Veranstaltungen

Log-Linear Attention: Die Zukunft der effizienten und ausdrucksstarken Transformer-Modelle

Eine tiefgehende Analyse von Log-Linear Attention, einer innovativen Methode zur Verbesserung der Effizienz und Leistungsfähigkeit von Transformern bei der Verarbeitung langer Sequenzen in der maschinellen Lernwelt.

Log-Linear Attention: Die Zukunft der effizienten und ausdrucksstarken Transformer-Modelle

Die Entwicklung von Transformern hat in den letzten Jahren das Gebiet des maschinellen Lernens revolutioniert. Sie bilden die Grundlage für viele fortschrittliche Anwendungen, von der natürlichen Sprachverarbeitung über Bildverarbeitung bis hin zu Sequenzmodellierung in der Biotechnologie. Ein zentrales Element dieser Architektur ist der sogenannte Attention-Mechanismus, der es ermöglicht, relevante Informationen aus Sequenzen zu extrahieren und zu gewichten, um so genauere Vorhersagen zu treffen. Dennoch ist der klassische Attention-Mechanismus mit erheblichen Herausforderungen verbunden, insbesondere hinsichtlich seiner Rechenkomplexität und seines Speicherbedarfs bei sehr langen Sequenzen. Hier setzt die neuartige Methode der Log-Linear Attention an, die eine vielversprechende Brücke zwischen Effizienz und Ausdrucksstärke schlägt. Der klassische Attention-Mechanismus in Transformern operiert mit einer quadratischen Rechenkomplexität in Bezug auf die Sequenzlänge.

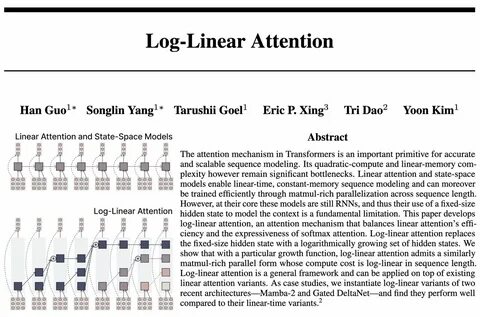
Dies bedeutet, dass die benötigte Rechenzeit und der Speicherbedarf mit der Länge der Eingabesequenz exponentiell zunehmen. Für Anwendungen, die sehr lange Sequenzen verarbeiten müssen, etwa in der Genomforschung oder bei langen Textpassagen, wird der Umgang mit diesem Aufwand schnell unpraktisch. Effizientere Ansätze wie Linear Attention und State-Space-Modelle haben versucht, dieses Problem zu mildern, indem sie eine lineare Zeitkomplexität und konstanten Speicherbedarf ermöglichen. Dabei werden oft rekurrente neuronale Netze (RNNs) genutzt, die durch ihre Wiederholungsstruktur skalierbar sind, aber dennoch Einschränkungen mit sich bringen, vor allem durch die Begrenzung auf einen festen, kleinen Hidden-State-Speicher. Die innovative Log-Linear Attention zielt genau auf diese Einschränkung ab, indem sie den festen Hidden State durch eine logarithmisch wachsende Sammlung von Hidden States ersetzt.

Dadurch wächst der repräsentative Kontext nicht linear mit der Sequenzlänge, sondern in einem günstigeren, log-linearen Verhältnis. Dies erhöht die Ausdruckskraft des Modells maßgeblich, da mehr Kontextinformationen erhalten und verarbeitet werden können, ohne dabei die Effizienz zu stark einzuschränken. Ein besonders bemerkenswerter Aspekt der Log-Linear Attention ist, dass sie sich nahtlos in die bisherige Infrastruktur der linearen Attention integrieren lässt. Das bedeutet, dass Modelle wie Mamba-2 oder Gated DeltaNet mit der Log-Linear Attention aufgerüstet werden können, um in ihrer Performance zu profitieren, ohne komplett neu entwickelt werden zu müssen. In ersten Fallstudien konnte gezeigt werden, dass diese Varianten gegenüber ihren rein linearen Gegenstücken deutlich besser abschneiden, sowohl was Genauigkeit als auch Berechnungseffizienz betrifft. Die Grundlage für die Effizienzsteigerung liegt in der speziellen Wachstumsfunktion der Hidden States, die das Modell nutzt.

Durch diese Funktion wird ermöglicht, dass die wichtigsten Kontextinformationen in einem logarithmisch wachsenden Speicher abgelegt werden können, während weniger wichtige Daten im Verlauf der Berechnung aggregiert werden. Dadurch entsteht ein eleganter Kompromiss zwischen der Notwendigkeit, möglichst viele Informationen aus der Eingabe zu erhalten, und dem praktischen Bedarf, Rechenressourcen zu schonen. Diese Idee spiegelt auch die generelle Tendenz wider, komplexe Systeme durch hierarchische und adaptive Speicherstrukturen leistungsfähiger und gleichzeitig effizienter zu gestalten. Log-Linear Attention trägt so zu einem besser skalierbaren Paradigma bei, das für viele großangelegte Anwendungen des maschinellen Lernens relevant ist. Neben technischen Vorteilen hat Log-Linear Attention auch einen positiven Einfluss auf die Trainingsfähigkeit von Modellen.

Durch die Reduzierung von Rechenkomplexität können Trainingsprozesse schneller durchgeführt werden, was wiederum zu einer leichteren Integration in praxisnahe Anwendungen führt. Dies ist besonders relevant, da die Trainingskosten für große Modelle eine der größten Herausforderungen in der aktuellen KI-Forschung darstellen. Darüber hinaus eröffnet die Log-Linear Attention interessante Möglichkeiten für neue Modellarchitekturen und hybride Ansätze, in denen die Vorteile von Transformer-Architekturen mit jenen rekurrenter Modelle kombiniert werden können. Die dadurch erzeugte Flexibilität vereinfacht es, maßgeschneiderte Lösungen für spezielle Aufgaben zu entwickeln, bei denen eine Balance zwischen Computereffizienz und inhaltlicher Tiefe erforderlich ist. Insgesamt zeigt die Einführung von Log-Linear Attention einen wichtigen Schritt in Richtung effizienterer und leistungsfähigerer neuronaler Netze.

Die Skalierbarkeit, die sie durch ihre besondere Speicher- und Berechnungsmethodik mitbringt, unterstützt die weitere Expansion von KI-Anwendungen in Bereiche mit extrem langen Datenreihen. Sei es bei der Analyse umfangreicher Textkorpora, bei der Modellierung komplexer zeitlicher Abläufe oder bei der Verarbeitung biologischer Sequenzen – die Möglichkeiten, die Log-Linear Attention bietet, sind vielfältig und vielversprechend. Die Weiterentwicklung dieser Technologie wird auch die Forschungsgemeinschaft nachhaltig beeinflussen, da neue Fragen hinsichtlich Optimierung, Parallelisierung und Anwendungsbreiten entstehen. Sie fordert Entwickler und Wissenschaftler heraus, kreativ mit neuen Architekturideen umzugehen und die Grenzen des Machbaren zu verschieben. Für Unternehmen und Forschungseinrichtungen bedeutet dies, dass effiziente und zugleich ausdrucksstarke Modelle zugänglicher werden, wodurch bislang schwer handhabbare Aufgaben lösbar werden können.

Dies kann zu Innovationen in zahlreichen Industriezweigen führen, von der Automatisierung über die Gesundheitsbranche bis hin zur Datenwissenschaft. Log-Linear Attention stellt somit nicht nur eine technische Verbesserung dar, sondern repräsentiert auch einen Paradigmenwechsel in der Art und Weise, wie Aufmerksamkeit in neuronalen Netzen modelliert und skaliert wird. Seine ausgewogene Mischung aus Effizienz und Modellierbarkeit bietet eine starke Basis für künftige Entwicklungen im Bereich der künstlichen Intelligenz und zeigt klar, wohin die Reise moderner Sequenzverarbeitung gehen kann.
OKX Partnerinhalte

Registrieren Sie sich bei OKX und erhalten Sie Ihren Willkommensbonus

OKX ist eine Plattform für Spot- und Futures-Handel, P2P-Tausch und Krypto-Sparpläne. Ein neues Konto über diesen Link eröffnet Zugang zum Willkommensbonus-Programm: bis zu 10.000 USDT für Ihre ersten Schritte an der Börse.

Konto erstellen und Bonus erhalten →

18+ · Partnerlink. Kryptowährungen sind volatil: Sie können Ihre Einlage verlieren.

Als Nächstes
Bitcoin bleibt über 105.000 US-Dollar trotz Donald Trumps Drohungen gegen Elon Musk
Samstag, 14. November 2026. Bitcoin bleibt über 105.000 US-Dollar trotz Donald Trumps Drohungen gegen Elon Musk

Bitcoin zeigt weiterhin eine bemerkenswerte Stabilität und Stärke, indem es den Wert von über 105. 000 US-Dollar hält – ein bemerkenswerter Meilenstein, vor allem vor dem Hintergrund der jüngsten Konflikte zwischen zwei prominenten Persönlichkeiten: Donald Trump und Elon Musk.

Dave Ramsey warnt: Fast 50 % der Amerikaner machen einen großen Fehler bei der Sozialversicherung – So vermeiden Sie ihn
Samstag, 14. November 2026. Dave Ramsey warnt: Fast 50 % der Amerikaner machen einen großen Fehler bei der Sozialversicherung – So vermeiden Sie ihn

Die Sozialversicherung spielt für Millionen Amerikaner eine zentrale Rolle als Einkommensquelle im Ruhestand. Doch fast die Hälfte der Bevölkerung macht einen entscheidenden Fehler, der ihre finanzielle Situation im Alter erheblich negativ beeinflusst.

Warum Costco-Aktien (COST) eine klügere Investition als Big Tech sein könnten
Samstag, 14. November 2026. Warum Costco-Aktien (COST) eine klügere Investition als Big Tech sein könnten

In der heutigen dynamischen Investmentlandschaft stehen Anleger häufig vor der Entscheidung, ob sie in etablierte Technologieunternehmen investieren oder alternative, stabile Werte wählen sollten. Während Big-Tech-Firmen wie Apple, Amazon, Google und Microsoft traditionell eine attraktive Option darstellen und das Wachstum im digitalen Zeitalter maßgeblich prägen, könnte es sich lohnen, einen genaueren Blick auf Unternehmen wie Costco zu werfen.

Effiziente Analyse von Claude Code Nutzung mit ccusage: Das unverzichtbare CLI Tool für Entwickler
Samstag, 14. November 2026. Effiziente Analyse von Claude Code Nutzung mit ccusage: Das unverzichtbare CLI Tool für Entwickler

In der heutigen Zeit, in der Künstliche Intelligenz und insbesondere Sprachmodelle immer stärker in Softwareprojekte integriert werden, gewinnt eine detaillierte und effiziente Nutzungskontrolle der Ressourcen eine immense Bedeutung. Für Entwickler, die Claude Code verwenden, ist ccusage ein unverzichtbares Werkzeug, um den Tokenverbrauch sowie die damit verbundenen Kosten schnell und transparent zu analysieren.

Firefox ändert Datenschutzversprechen: Was Nutzer jetzt wissen müssen
Samstag, 14. November 2026. Firefox ändert Datenschutzversprechen: Was Nutzer jetzt wissen müssen

Mozilla Firefox, eine der bekanntesten und meistgenutzten Internetbrowser, hat kürzlich eine bedeutende Änderung an seiner Datenschutzrichtlinie vorgenommen, die für viel Aufsehen und Verunsicherung in der Nutzercommunity sorgt. Das Unternehmen hat das langjährige Versprechen, niemals persönliche Daten seiner Nutzer zu verkaufen, gelöscht.

Neural Rigidity bei Autismus: Wie Nichtinvasive Methoden Verhaltensweisen Verändern Können
Samstag, 14. November 2026. Neural Rigidity bei Autismus: Wie Nichtinvasive Methoden Verhaltensweisen Verändern Können

Autismus-Spektrum-Störungen (ASS) sind komplexe neurologische Entwicklungsvarianten, die durch atypische soziale Interaktion, Kommunikation und repetitive Verhaltensmuster charakterisiert sind. Während die Forschung jahrzehntelang versucht hat, die biologischen Grundlagen dieser Erkrankung zu verstehen, öffnet sich mit modernsten nichtinvasiven Behandlungsmethoden ein vielversprechendes Feld, das auf die Modulation neuronaler Dynamiken zielt.

Warum die Aktie der Mosaic Company (MOS) am Freitag stark gefallen ist
Samstag, 14. November 2026. Warum die Aktie der Mosaic Company (MOS) am Freitag stark gefallen ist

Am vergangenen Freitag erlebte die Aktie der Mosaic Company (MOS) einen signifikanten Kursrückgang, der viele Investoren und Marktbeobachter gleichermaßen überraschte. Die Mosaic Company ist ein weltweit führendes Unternehmen im Bereich der Produktion von Düngemitteln, insbesondere Phosphat- und Kali-Dünger, die eine zentrale Rolle in der globalen Landwirtschaft spielen.

Weitere Artikel zum Thema
Warum DOGE und SHIB trotz Elon Musks süßer Hunde-Posts weiter fallen
Freitag, 13. November 2026. Warum DOGE und SHIB trotz Elon Musks süßer Hunde-Posts weiter fallen

Im März 2025 sorgte Elon Musk erneut für Aufsehen, als er auf der Social-Media-Plattform X, früher bekannt als Twitter, ein Bild mit mehreren Hunden und Münzen postete. Darunter befand sich auch eine Darstellung des Shiba Inu, der ikonische Hund, der als Vorlage für diverse Meme-Coins wie Dogecoin (DOGE) und Shiba Inu (SHIB) dient.

Mattel pausiert Hot Wheels Virtual Garage NFTs: Was steckt hinter der Entscheidung?
Samstag, 14. November 2026. Mattel pausiert Hot Wheels Virtual Garage NFTs: Was steckt hinter der Entscheidung?

Mattel, einer der weltweit führenden Spielzeughersteller, hat kürzlich bekannt gegeben, dass das Projekt Hot Wheels Virtual Garage NFTs vorerst eingestellt wird. Diese Ankündigung sorgt in der Sammler- und NFT-Community für Aufsehen, denn sie zeigt, wie dynamisch und herausfordernd der Markt für digitale Sammlerstücke sein kann – insbesondere wenn traditionelle Marken wie Hot Wheels ihre Präsenz im Krypto- und NFT-Bereich ausbauen.

Bitcoin steht vor Risiko eines Rückgangs auf 75.000 USD bei Bruch der 83.000 USD Unterstützung – Technische Analyse im Fokus
Samstag, 14. November 2026. Bitcoin steht vor Risiko eines Rückgangs auf 75.000 USD bei Bruch der 83.000 USD Unterstützung – Technische Analyse im Fokus

Bitcoin, die bekannteste Kryptowährung weltweit, zeigt derzeit Anzeichen von erhöhter Volatilität und Unsicherheit auf dem Markt. Nach einer starken Erholungsphase in den vergangenen Wochen ist der Kurs bei etwa 86.

KI-Agenten: Weniger Hype, Mehr Verlässlichkeit für den echten Mehrwert
Samstag, 14. November 2026. KI-Agenten: Weniger Hype, Mehr Verlässlichkeit für den echten Mehrwert

Im Jahr 2025 werden KI-Agenten von vielen als die nächste große Revolution in der Technologiebranche gefeiert. Die Fortschritte bei günstigeren Modellen, innovativen Werkzeugen wie Multi-Component-Processing (MCP), Gedächtnis-Funktionalitäten und Rapid Automated Generation (RAG) sowie zehnfach gesteigerte Inferenzgeschwindigkeiten lassen die Erwartungen an KI-Agenten enorm steigen.