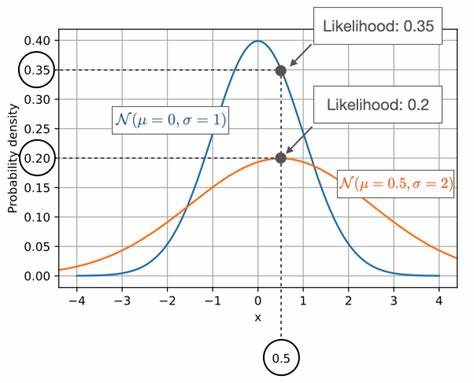
In der Welt der biologischen Forschung und der künstlichen Intelligenz haben Sprachmodelle eine bemerkenswerte Rolle eingenommen, insbesondere bei der Analyse und Vorhersage der Lebensfähigkeit von biologischen Sequenzen wie Aminosäuren oder Nukleotiden. Diese Modelle werden auf umfangreichen Datensätzen trainiert, um die komplexen Regeln zu verstehen, nach denen biologische Sequenzen aufgebaut sind. Ein zentraler Aspekt dabei ist die Fähigkeit dieser Modelle, Wahrscheinlichkeitswerte (Likelihoods) für bestimmte Sequenzen zu erzeugen, die als Indikator für deren biologische Fitness und Funktion dienen sollen. Doch die jüngsten Erkenntnisse zeigen, dass In-Context Learning, eine Technik, bei der Modelle durch Beispiele innerhalb einer Eingabe ihre Antworten anpassen, die Beziehung zwischen diesen Wahrscheinlichkeiten und der tatsächlichen Fitness der Sequenzen verzerren kann.
In-Context Learning gewinnt zunehmend an Bedeutung, da es Modellen ermöglicht, gezielt auf vorgegebene kontextuelle Informationen zu reagieren, ohne dabei explizit neu trainiert werden zu müssen. Dies ist besonders für komplexe biologische Anwendungen interessant, bei denen sich die Muster und Regeln schnell ändern können. Allerdings offenbart sich bei genauerer Betrachtung, dass diese Technik unter bestimmten Umständen dazu führt, dass das Modell Sequenzen mit wiederkehrenden Motiven überbewertet, indem es die Wiederholung als starken Beleg für Richtigkeit interpretiert. Das führt zu anomalen, also unerwartet hohen Wahrscheinlichkeitswerten für solche Sequenzen, auch wenn diese biologisch nicht unbedingt fitter oder funktionaler sind. Die Ursache dieses Effekts liegt in der Arbeitsweise moderner Transformer-Modelle, die sich insbesondere in der biologischen Sequenzanalyse als äußerst leistungsfähig erwiesen haben.
Transformer operieren oft durch sogenannte Masked Language Modeling-Aufgaben, bei denen Teile einer Sequenz verdeckt werden und das Modell deren Identität anhand des restlichen Kontextes erraten muss. Wenn eine Sequenz in sich wiederholte Motive enthält, nutzt das Modell diese Wiederholung als Referenz, um die verdeckten Teile zu identifizieren – ein Prozess, der als Lookup-Operation bezeichnet werden kann. Dieses Verhalten sorgt für eine Art „Kurzschluss“ im Modellverständnis, worin es sich stärker auf direkte Wiederholungen als auf die ursprünglich gelernten biologischen Regeln stützt. Das bedeutet, dass die gelernten Prioritäten des Modells zugunsten der Suche nach identischen Sequenzteilen übergangen werden. Das kann besonders problematisch sein, wenn solche Wiederholungen unnatürlich oder überrepräsentiert sind, wie bei künstlichen oder manipulierten Sequenzen.
Gerade in der biologischen Forschung, wo zarte Unterschiede entscheidende Auswirkungen auf Funktionalität und Fitness haben können, verzerrt das die Interpretation der Score-Werte erheblich. Nicht nur perfekt wiederholte Motive, sondern auch leicht variierten Wiederholungen oder komplementäre Muster, wie etwa die inversen Sequenzen in RNA-Strukturen, sind von dieser Verzerrung betroffen. Das Ergebnis ist eine generell eingeschränkte Verlässlichkeit der bisherigen Wahrscheinlichkeitswerte als Fitness-Indikator. Forscher müssen daher äußerst vorsichtig sein, wenn sie Sprachmodelle mit In-Context Learning in sensiblen biologischen Anwendungen einsetzen. Die Auswirkungen dieser Erkenntnisse sind vielschichtig. Zum einen unterstreichen sie die Notwendigkeit, die Interpretationsmodelle für Wahrscheinlichkeitswerte grundlegend zu überdenken und gegebenenfalls weitere Kontrollmechanismen einzuführen, die Verzerrungen vermeiden oder zumindest kompensieren können.
Zum anderen werfen sie die Frage auf, wie gut aktuelle Trainingsmethoden und Modellarchitekturen tatsächlich biologische Realitäten abbilden. Es lässt sich darüber hinaus vermuten, dass die in der maschinellen Sprachverarbeitung entwickelte Technik des In-Context Learnings bei biologischen Sequenzen bisher noch nicht ausreichend angepasst wurde, um die speziellen Eigenschaften dieser Datenform vollständig zu berücksichtigen. Die biologische Fitness von Sequenzen ist nicht nur eine Frage des wiederholten Musters, sondern hängt von einer Vielzahl biochemischer und evolutionärer Faktoren ab, die weit über einfache Sequenzähnlichkeit hinausgehen. Hier kann es notwendig sein, hybride Modelle zu entwickeln, die sowohl das Verständnis tiefer biologischer Zusammenhänge als auch die leistungsfähigen sprachlichen Manipulationen eines In-Context Learning vereinen.
Die aktuellen Studien zeigen ebenso auf, dass unterschiedliche Modellarchitekturen unterschiedlich stark von dieser Verzerrung betroffen sind. Besonders Transformer-basierte Modelle scheinen oft anfälliger zu sein, während andere Architekturen möglicherweise robuster gegenüber solchen Fehlerquellen sind. Das eröffnet Chancen für weitere Forschung und gezielte Optimierungen, um die vollen Potenziale von KI-gestützten Analysen biologischer Sequenzen effektiv und verlässlich zu nutzen. Darüber hinaus ist es wichtig, die Rolle von Trainingsdaten auf diese Problematik zu reflektieren. Die Datenbasis, auf der Sprachmodelle trainiert werden, kann unbewusst Muster verstärken oder Ungleichgewichte schaffen, die wiederum die Tendenz zu solchen Lookup-basierten Fehlinterpretationen fördern. Eine sorgfältige Auswahl und Diversifizierung der Trainingssequenzen sowie neue Lernstrategien könnten dazu beitragen, diese Verzerrungen zu minimieren und die Verlässlichkeit von Prognosen zu verbessern.
Für die angewandte biologische Forschung bedeutet das letztlich, dass die alleinige Abhängigkeit von KI-gestützten Wahrscheinlichkeitswerten zur Bestimmung der Fitness von Sequenzen nicht ausreichend ist. Es empfiehlt sich, diese Ergebnisse immer im Zusammenspiel mit experimentellen Daten und biologischem Fachwissen zu betrachten. Nur so können Fehlinterpretationen vermieden und fundierte Erkenntnisse gewonnen werden. Zusammenfassend lässt sich sagen, dass In-Context Learning zwar enorme Chancen für die Modellierung und Analyse biologischer Sequenzen bietet, gleichzeitig aber auch neue Herausforderungen mit sich bringt. Die Verzerrung der Beziehung zwischen Sequenzwahrscheinlichkeiten und biologischer Fitness durch Wiederholungseffekte und Lookup-Operationen hebt die Grenzen auf, innerhalb derer aktuelle Modelle eingesetzt werden können.
Die zukünftige Forschung wird sich darauf konzentrieren müssen, diese Effekte besser zu verstehen, geeignete Gegenmaßnahmen zu entwickeln und die Modelle so weiterzuentwickeln, dass sie die komplexe Natur biologischer Systeme möglichst präzise und aussagekräftig abbilden. Die rasante Entwicklung im Bereich der künstlichen Intelligenz und insbesondere im Einsatz von Sprachmodellen für biologischen Kontext hält weiterhin großes Potenzial bereit. Entscheidend wird dabei sein, die gewonnenen Erkenntnisse zu nutzen, um die Zuverlässigkeit biotechnologischer Anwendungen und die Qualität wissenschaftlicher Analysen zu steigern. Nur durch das harmonische Zusammenspiel von technologischem Fortschritt und tiefer biologischer Einsicht können wir die volle Kraft moderner KI-Methoden nachhaltig nutzen und zukünftige Innovationen in Medizin, Biotechnologie und Evolutionstheorie vorantreiben.