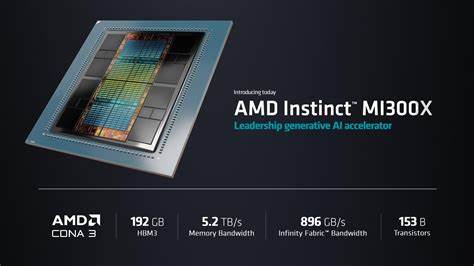
Die AMD MI300X GPU stellt eine bedeutende technische Errungenschaft im Bereich der Hochleistungsrechner und KI-Beschleuniger dar. Mit innovativer Hardwarearchitektur und hochoptimierten Kommunikationswegen hebt sie die Performance bei Datentransfers zwischen GPUs auf ein neues Level. Besonders im Kontext verteilter Systeme, in denen große Sprachmodelle (Large Language Models, LLMs) trainiert und eingesetzt werden, sind schnelle und effiziente Datenübertragungen zwischen GPUs unerlässlich. Das Memcpy Peer Benchmark zur Bewertung der Bandbreite und Latenz bei Speicherzugriffen zwischen verschiedenen MI300X-Grafikkarten liefert dabei aufschlussreiche Erkenntnisse über die Leistungsfähigkeit der Infinity Fabric Verbindungen und das interne Netzwerkdesign der MI300X. Die AMD MI300X ist mit 192 GB HBM3E Speicher ausgestattet, welcher eine beeindruckende theoretische Bandbreite von 5,3 TB/s liefert.
Ein weiterer wesentlicher Faktor ist die Infinity Fabric, AMDs leistungsstarke Interconnect-Technologie mit einer Bandbreite von 50 GB/s pro Link. In einem System mit acht MI300X GPUs sind jeweils sieben Infinity Fabric Links pro GPU direkt verbunden, wodurch eine vollständig vernetzte Mesh-Topologie entsteht. Diese einzigartige Architektur ermöglicht eine direkte Kommunikation von jeder GPU zu jeder anderen GPU ohne Notwendigkeit eines Zwischenhops über andere GPUs oder die CPU. Die Vorteile dieser Netzwerkstruktur zeigen sich besonders bei Peer-to-Peer Speicheroperationen, bei denen Daten zwischen Grafikspeichern unterschiedlicher GPUs kopiert werden. Memcpy Peer ist dabei ein wichtiger Indikator für komplexe kollektive Kommunikationsoperationen wie All-Reduce, All-Gather oder Scatter-Reduce, die für effizientes Distributed Training großer Modelle maßgeblich sind.
In Umgebungen, in denen regelmäßig Synchronisationen großer Tensoren zwischen GPUs erforderlich sind, kann diese optimierte Peer-to-Peer-Kommunikation beträchtliche Leistungssteigerungen bewirken. Benchmark-Analysen der Memcpy Peer Leistung zeigen, dass bei kleinen Datenmengen die Bandbreite naturgemäß niedrig ist, da der Protokolloverhead und andere fixe Zeiten die Übertragung dominieren. Doch mit wachsender Datenmenge steigt die Bandbreitenauslastung schnell an und erreicht bei bereits 8 bis 16 MB Datenübertragungen fast die theoretische maximale Bandbreite von 50 GB/s. Die Skala der Benchmark-Daten enthüllt eine nahezu lineare Steigerung der Bandbreite auf einer logarithmischen Skala von 100 KB bis 8 MB, was den Bereich markiert, in dem Optimierungen besonders wirksam sind. Über 32 MB bleibt die Bandbreite nahezu konstant – hier wird das volle Potential der Infinity Fabric ausgenutzt.
Diese Erkenntnisse sind für Entwickler, die große Sprachmodelle trainieren oder inferieren, von großer Bedeutung. Sie verdeutlichen, dass Datenpartitionierungsstrategien auf möglichst große Nachrichtenmengen abzielen sollten. Kleine Transfers unter 1 MB weisen eine deutlich niedrigere Auslastung auf, teilweise nur etwa 20 Prozent des maximal möglichen Durchsatzes. Daher empfiehlt es sich, kleine Mitteilungen zu aggregieren, um Protokollkosten zu amortisieren und so die Kommunikationslatenz zu minimieren. Ein Vergleich des Memcpy Peer Benchmarks mittels PyTorch und einem spezialisierten GPU-unterstützten MPI (Message Passing Interface) zeigt interessante Unterschiede. Während PyTorch etwa 8 MB große Nachrichten benötigt, um die 40 GB/s Herausforderung zu erreichen, gelingt MPI bereits ab 1 MB Transfergröße eine ähnliche Bandbreitenauslastung.
Dies verweist auf optimierte Kommunikationsprotokolle und Treiber in der MPI-Implementierung, die Overhead reduzieren und somit Datenströme schneller durch die Hardware leiten. Die MPI-Benchmark-Ergebnisse bestätigen zudem, dass ein Nachrichtengröße von rund 16,8 MB mindestens nötig ist, um über 80 Prozent der maximalen Bandbreite zu erzielen; bei 33,6 MB werden mehr als 90 Prozent erreicht. Dies unterstreicht, dass für hochleistungsfähige Anwendungen die Bündelung von Daten in möglichst großen Tranchen empfohlen wird. Der MI300X speist den Speicherzugriffskanal mit direktem GPU-zu-GPU-Datentransfer über die Infinity Fabric, wodurch zusätzliche Verzögerungen, die bei Mehrhops oder Umwegen über die CPU auftreten, entfallen. Die vollständig vermaschte Netzwerktopologie eliminiert Engpässe im Kommunikationspfad, was für HPC-Systeme und KI-Großmodelle, deren Trainings- und Inferenzphasen häufig auf niedrigste Latenz und höchste Bandbreiten angewiesen sind, ideal ist.
Die gemessenen Bandbreitenlimitierungen liegen also primär nicht in der GPU-internen Speicherarchitektur oder HBM-Leistung, sondern tatsächlich in der Kapazität der einzelnen Infinity Fabric Links. Die einzelnen Links stellen mit 50 GB/s eine klare physische Obergrenze dar, die durch die effiziente Implementierung von Protokollen nahezu vollständig ausgeschöpft werden kann. Ein Ausbau der Gesamtbandbreite wird somit nur durch den parallelen Einsatz mehrerer Links oder durch zukünftige Generationen der Interconnect-Technologie realisiert werden können. Auf Softwareseite sind Optimierungen in Messaging- und Kommunikationsbibliotheken entscheidend. Die praktische Nutzung des Memcpy Peer APIs über PyTorch ermöglicht eine einfache Integration in Trainingspipelines von ML-Anwendern, doch der höhere Overhead bedingt größere Nachrichten für maximale Effizienz.
Alternativ weist die MPI-basierte Kommunikation durch ihre fein abgestimmten Protokolle eine schnellere Erreichung von Peak-Bandbreite auf. Für Entwickler bedeutet dies, dass das Verständnis der zugrunde liegenden Implementierung entscheidend für die Gestaltung optimaler Kommunikationsmuster ist. Cacheeffekte spielen ebenfalls eine Rolle bei kleinen Datenmengen. Da die Benchmarks keine expliziten Cache-Flushing-Mechanismen einsetzen, beeinflusst der L2 Cache die Messergebnisse. Für kleine Transfers, die im Cache bleiben, kann dies zu höheren gemessenen Bandbreiten führen. Gleichzeitig müssen Entwickler bedenken, dass Overhead und Synchronisationskosten bei kleinen Transfers dominant sind und die effektive Bandbreite stark einschränken. Die verwendete Benchmark-Implementierung in PyTorch beruht auf der Methode copy_ für das in-place Kopieren von Tensoren zwischen unterschiedlichen GPUs.
Die Durchführung des Benchmarks wird durch GPU-spezifische Mechanismen wie CUDA Events zur exakten Timing-Messung unterstützt, um asynchrone Ausführungen korrekt zu erfassen. Die Benchmark läuft so lange, bis mindestens eine Sekunde Messzeit erreicht ist, um Schwankungen im Timing auszugleichen und stabile Resultate zu gewährleisten. Der gespeicherte Quellcode zur Durchführung der Benchmarks ist offen zugänglich, was für Transparenz und Reproduzierbarkeit sorgt. Auch die MPI-basierte Implementierung ist öffentlich verfügbar und nutzt eigens angepasste GPU-spezifische OpenMPI Builds, die eng mit dem AMD ROCm Ökosystem verzahnt sind. Diese Integration garantiert ein möglichst effizientes Zusammenspiel zwischen Hardware, Treiber, Netzwerk und Software. Insgesamt zeigt die Analyse des MI300X Memcpy Peer Benchmarks diese GPU als Maßstab für moderne Hochleistungsarchitektur im Segment der KI- und HPC-Anwendungen.
Die Kombination aus schnellem HBM3E Speicher, leistungsstarker Infinity Fabric Vernetzung und optimierten Software-Schnittstellen resultiert in durchgängig hoher Datenübertragungsrate zwischen GPUs. Für die Entwicklung verteilter Trainings-Frameworks bedeutet dies, dass durch strategische Anpassungen an Nachrichten- und Partitionsgrößen erhebliches Potential zur Beschleunigung von Lern- und Inferenzprozessen realisiert werden kann. Zukünftige Systeme werden voraussichtlich noch umfassendere Netzwerktopologien und höhere Link-Durchsatzraten bieten, doch der MI300X stellt schon heute eine zukunftsweisende Plattform für die nächste Generation von KI- und HPC-Anwendungen dar. Die Kenntnis der Details aus der Memcpy Peer Leistungsstudie bietet Entwicklern und Systemarchitekten wichtige Hinweise, wie sie bestehende und kommende Ressourcen bestmöglich nutzen können, um maximale Rechen- und Kommunikationsperformance zu erzielen.
Für mittelschwere bis große AI Workloads empfiehlt sich daher die Gestaltung der Kommunikationsstrategie so, dass Datenpakete in Größen über 16 MB übertragen werden. So lassen sich Overheadkosten minimieren und die vorhandene Bandbreite nahezu optimal ausnutzen. Die Vermeidung kleiner, häufig verteilte Nachrichten fördert zudem die Skalierbarkeit und Stabilität des Gesamtsystems. Zusammenfassend unterstreicht die Memcpy Peer Analyse, wie essentiell eine ganzheitliche Abstimmung von Hardware-Architektur, Netzwerktopologie und Software-Protokollen ist, um den Herausforderungen der heutigen und zukünftigen KI- und HPC-Rechenaufgaben gerecht zu werden. AMD MI300X mit seiner konsequent auf direkte GPU-Kommunikation ausgelegten Key-Technologie liefert hier wichtige Impulse und setzt einen hohen Standard für Peer-to-Peer Speichertransfers zwischen GPUs.