Die rasante Entwicklung großer Sprachmodelle (Large Language Models, LLMs) hat das Feld der künstlichen Intelligenz in den letzten Jahren massiv vorangetrieben. Ihre Fähigkeit, komplexe Sprache zu verstehen und zu generieren, eröffnet unzählige Anwendungsmöglichkeiten – von der automatischen Textgenerierung bis hin zur Problemlösung in spezialisierten Fachgebieten wie Mathematik. Dennoch stellt das Training dieser Modelle, um präzises und nachvollziehbares logisches Denken zu fördern, eine große Herausforderung dar. Traditionell benötigen solche Modelle Tausende von Trainingsbeispielen und eine erhebliche Rechenleistung, um mathematisches Reasoning und genaue Problemlösung zu gewährleisten.
Eine neuartige Forschungsarbeit hat jedoch eindrucksvoll gezeigt, dass bereits ein einziges sorgfältig ausgewähltes Trainingsbeispiel in Verbindung mit verstärkendem Lernen (Reinforcement Learning, RL) ausreicht, um die mathematischen Fähigkeiten eines Sprachmodells deutlich zu verbessern – ein Ansatz, der als Reinforcement Learning with Verifiable Reward (RLVR) bekannt ist. Diese Technik könnte die Art und Weise, wie wir LLMs trainieren und weiterentwickeln, maßgeblich verändern. Im Zentrum der Untersuchung steht das Modell Qwen2. 5-Math-1. 5B, ein speziell auf mathematische Aufgaben ausgerichtetes Sprachmodell mit etwa 1,5 Milliarden Parametern. Das Besondere dieses Ansatzes ist, dass es mit nur einem einzigen Trainingsbeispiel gelingen konnte, die Leistung auf dem MATH500-Benchmark von 36,0% auf beeindruckende 73,6% zu steigern. Dieser Leistungssprung entspricht der Performance, die früher mit einem umfangreichen Trainingsdatensatz von mehr als 1. 200 Beispielen erreicht wurde.
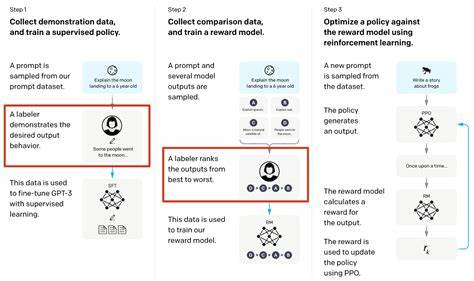
Solche Resultate machen eindrucksvoll deutlich, dass die Qualität des Trainingsinputs und die Art der Lernoptimierung manchmal entscheidender sein können als reine Datenmenge. Der Kernmechanismus hinter RLVR ist die Belohnungsauswertung anhand von Verifizierbarkeit. Anders als herkömmliche Belohnungen, die oft diffus oder subjektiv sind, basiert dieser Ansatz auf dem klaren Nachweis korrekter Lösungsschritte oder Endergebnisse, vor allem bei mathematischen Problemen. Durch den Einsatz von verstärkendem Lernen überwacht das Modell, wie gut seine Antworten zu einem überprüfbaren Ziel führen, und passt seine Strategie iterativ an. Dieses Belohnungskonzept fördert die Entwicklung einer robusteren und präziseren Argumentationsfähigkeit, die über einzelne Trainingsbeispiele hinausgeht. Ein besonders hervorzuhebendes Phänomen bei diesem Verfahren ist die sogenannte post-saturation generalization.
Hierbei verbesserte sich das Modell selbst nach dem Erreichen einer Plateau-ähnlichen Trainingsgenauigkeit weiterhin bei Testaufgaben. Das deutet darauf hin, dass das Modell durch die Trainingsdynamik noch tiefergehende Muster und Strategien entdeckt, die über die unmittelbare Beispielmenge hinaus wirksam sind. Dieses Verhalten zeigt, dass der Lernprozess nicht nur Reproduktion von gelerntem Wissen ist, sondern tatsächlich eine Art Verstehen und verallgemeinerte Problemlösungsfähigkeiten entsteht. Eine weitere interessante Beobachtung ist die cross-domain generalization. Das Modell entwickelte ungeplant die Fähigkeit, bei Aufgabenstellungen aus anderen Fachgebieten oder Formaten besser zu performen, obwohl das Training lediglich auf mathematischen Beispielen stattfand. Dies weist darauf hin, dass die Verstärkung des Denkprozesses und der explorativen Verhaltensweisen im Lernprozess die Flexibilität des Modells erhöht und es befähigt, sein Wissen situationsübergreifend anzuwenden.
Im Vergleich zu Modellvarianten mit größeren Parameterzahlen oder anderen RL-Algorithmen, wie beispielsweise PPO (Proximal Policy Optimization) und GRPO (Guided Reward Policy Optimization), zeigte sich, dass die Verbesserungen konsistent wären. Die Wahl des Algorithmus beeinflusst also zwar Feinheiten der Trainingsdynamik, doch die zentrale Idee eines einzelnen, hochwirksamen Trainingsbeispiels mit RL bleibt universell wirksam. Dies unterstreicht, dass ein gezieltes Training die herkömmliche Devise von möglichst vielen Daten zum Teil stark infrage stellt. Eine wichtige Rolle spielt auch die Förderung der Exploration innerhalb des Modells. Dabei wird nicht nur das unmittelbare Ziel verstärkt, sondern eine bewusst integrierte Form von Unvorhersehbarkeit in den Antwortmustern unterstützt. Dies wird meist über einen Entropieverlust realisiert, der mit einer geeigneten Gewichtung beim Training künstlich erhöht wird.
Interessanterweise verbessert sich die Performance des Modells selbst dann deutlich, wenn nur die Entropie ohne eine explizite Belohnung für Ergebnisse maximiert wird. Bei Qwen2. 5B führte das alleinige Hinzufügen von Entropieverlust zu einer Leistungssteigerung von 27,4% auf dem MATH500-Benchmark. Dieser Befund legt nahe, dass das Ausprobieren vielfältiger Lösungen die Lernfähigkeit des Modells grundlegend verbessert und kreatives Denkverhalten fördert. Das Phänomen von „grokking“, das in früheren Studien als langsames Erwachen von Verständnis beschrieben wurde, kann hier als Alternative zum erklärten Erfolg ausgeschlossen werden. Die Vorteile von 1-shot RLVR entstehen primär durch den Policy-Gradient-Verlust, eine Loss-Funktion, die das Modell direkt zu besseren Entscheidungsstrategien führt. Dies zeigt, dass eine gezielte, optimierte Verstärkungstaktik weitaus ergiebiger sein kann als das einfache, über lange Zeiträume verteilte Lernen aus großen Datenmengen.
Der große Schritt hin zu einem „1-shot“-Ansatz mit überprüfbarer Belohnung fordert die KI-Community auch dazu auf, sowohl bestehende Methoden der Trainingsdatenerstellung als auch Trainingsmechanismen neu zu überdenken. Die Effizienzgewinne und die dramatische Verbesserung mit minimaler Datenmenge lassen vermuten, dass sich zukünftig völlig neue Trainigsparadigmen etablieren könnten, in denen Qualität vor Quantität steht. Weiterhin eröffnet sich dadurch der Weg für spezielle Anwendungsbereiche, in denen umfangreiche Trainingsdaten rar oder gar nicht verfügbar sind. Für Entwickler und Forschende bedeutet dies einen großen Fortschritt. Sie können vorhandene oder kleinere Modelle durch gezieltes, effizient gestaltetes RLVR-Training erheblich aufwerten, ohne auf massive Rechenressourcen und Datenmenge angewiesen zu sein. Dies kann insbesondere für den Einsatz in spezialisierten Fachgebieten, Forschungslaboren oder sogar in ressourcenschwächeren Umgebungen von Vorteil sein.
Zusammengefasst steht die Methode des reinforcement learning with verifiable reward mit einem einzigen Trainingsbeispiel für eine neue Ära im maschinellen Lernen, bei der durch sorgfältig konzipierte Lernstrategien und -ziele tiefgreifende Leistungsverbesserungen möglich sind. Der Erfolg auf mathematischen Benchmarks wie MATH500 unterstreicht die Relevanz der Methode und zeigt die Potenziale für skalierbare und nachhaltige KI-Modelle mit höherer Problemlösungsfähigkeit. Die offene Bereitstellung von Code, Modellen und Daten fördert zudem die schnelle Nachverfolgung und Weiterentwicklung dieser innovativen Trainingsmethode innerhalb der wissenschaftlichen Gemeinschaft. Die Erkenntnisse über post-saturation generalization, cross-domain generalization und die Bedeutung der Exploration werden die zukünftige Forschung prägen und den Weg zu hochleistungsfähigen, selbsterklärenden KI-Systemen ebnen.
KI-Enthusiasten und Forschungsexperten sollten diese Entwicklung genau beobachten, denn sie könnte die nächsten Durchbrüche im Deep Learning und der automatisierten Wissensverarbeitung mitbestimmen.