In den letzten Jahren hat sich die künstliche Intelligenz in beeindruckendem Tempo weiterentwickelt. Besonders die Fortschritte im Bereich des maschinellen Lernens und speziell im Reinforcement Learning (RL) haben viele technische und wissenschaftliche Durchbrüche ermöglicht. Dennoch bleibt eine bedeutende Frage offen: Skalieren alle Methoden des Reinforcement Learning gleichermaßen? Während Techniken wie die Vorhersage des nächsten Tokens bei Sprachmodellen, denoisierende Diffusionsmodelle und kontrastives Lernen hervorragend mit wachsender Datenmenge und Modellgröße skaliert haben, zeigt sich bei Q-Learning, einer der am häufigsten eingesetzten Off-Policy-RL-Methoden, ein anderes Bild. Trotz seines Potenzials ist Q-Learning bislang noch nicht in der Lage, komplexe, langzeitige Entscheidungsprobleme in großem Maßstab zu lösen. In diesem Beitrag wollen wir die Gründe dafür beleuchten, die Herausforderungen verstehen und mögliche Ansätze für bessere Skalierbarkeit diskutieren.
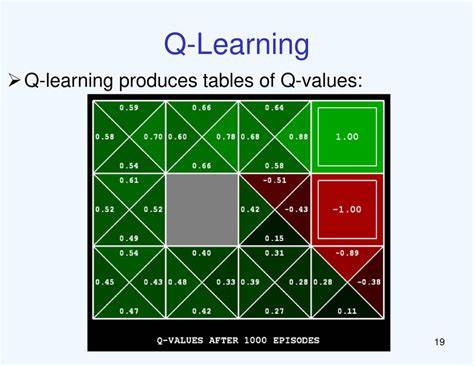
Q-Learning ist eine der beliebtesten Methoden im Reinforcement Learning, insbesondere im Bereich des Off-Policy-Lernens. Das zentrale Prinzip von Q-Learning ist die Schätzung der sogenannten Q-Funktion, die den erwarteten zukünftigen Nutzen einer Handlung in einem bestimmten Zustand beschreibt. Die Methode verwendet Timer-Differenz-Lernen (TD-Learning), um die Schätzungen iterativ zu verbessern, basierend auf bereits gesammelten Daten. Besonders ansprechend ist, dass Off-Policy-Methoden wie Q-Learning theoretisch jede Datenquelle nutzen können – egal ob die Daten von der aktuellen oder einer früheren Version der Strategie stammen. Gerade für Probleme in der realen Welt, wo Datenerzeugung teuer oder zeitaufwendig ist, bietet sich diese Eigenschaft an. Allerdings zeigt die praktische Erfahrung und aktuelle Forschung, dass Q-Learning insbesondere bei langwierigen, komplexen Aufgaben oftmals an seine Grenzen stößt.
Die zentrale Schwierigkeit liegt darin, wie das Modell seine Lernziele definiert. Im Gegensatz zu anderen skalierbaren Lernobjektiven, die unverzerrte oder zumindest kontrollierbare Zielgrößen verwenden, arbeitet Q-Learning mit sogenannten bootstrapped Targets, die einen systematischen Bias enthalten können. Dieser Verzerrungseffekt summiert sich über mehrere Schritte hinweg, insbesondere bei Aufgaben mit langen zeitlichen Horizonte, wodurch das Lernen zunehmend instabil und ungenau wird. In der Praxis bedeutet das, dass Q-Learning bei Problemen, die mehr als etwa 100 Entscheidungsstufen umfassen, oft nicht mehr in der Lage ist, eine zufriedenstellende Leistung zu erzielen. Dies steht im starken Kontrast zu den Erfolgen von On-Policy-Verfahren wie PPO (Proximal Policy Optimization) oder REINFORCE, die bei vielen komplexen Anwendungen wie Brettspielen oder der Feinabstimmung von Sprachmodellen den Durchbruch erzielt haben.
Interessanterweise erkennen auch führende Forschungsgruppen an, dass On-Policy-Methoden im Moment effizienter skalieren, da sie stets frische Daten vom aktuellen Modell benötigen und dadurch Bias-Probleme in der Wertschätzung minimieren können. Diese Abhängigkeit von immer neuen Rollouts stellt in einigen Forschungsdomänen, etwa bei Spielen oder simulierten Umgebungen, kein großes Problem dar, da sich dort Daten schnell und kostengünstig erzeugen lassen. Anders sieht es aber in realen Szenarien aus, insbesondere in der Robotik. Ein physischer Roboter benötigt viel Zeit, um die riesigen Datenmengen zu erzeugen, die für On-Policy-RL oft notwendig sind, und menschliche Betreuung zur Wartung und Reset der Experimente ist unverzichtbar. Hier würde Off-Policy-Learning mit Q-Learning theoretisch enorme Vorteile bieten, da es historische Daten mehrfach wiederverwenden könnte.
Doch die Realität zeigt: Trotz massiver Datenmengen und spezialisierter Algorithmen bleiben die Ergebnisse von Q-Learning auf komplexen realweltlichen Aufgaben oft hinter den Erwartungen zurück. Ein kürzlich publiziertes Forschungspapier hat sich eingehend mit dieser Problematik beschäftigt und eine Reihe von hochkomplexen, bisher ungelösten Aufgaben im Bereich Robotik und Navigation erstellt. Dabei wurde eine nahezu unbegrenzte Datenbasis verwendet, um Überanpassung zu vermeiden, und dennoch konnten verschiedene Standard-Off-Policy-Methoden wie IQL, SAC+BC oder CRL die Aufgaben nicht zufriedenstellend lösen. Dieses Experiment unterstreicht die zentrale Aussage, dass bloßes Skalieren von Daten und Rechenressourcen nicht ausreicht, um die Grenzen von Q-Learning zu überwinden. Ein Schlüsselbegriff im Zusammenhang mit der Schwierigkeit von Q-Learning ist der sogenannte "Curse of Horizon" – der Fluch der Zeithorizonts.
Je länger der Zeitraum, über den Entscheidungen getroffen und bewertet werden müssen, desto stärker akkumulieren sich die im Lernziel vorhandenen Verzerrungen. Dies führt zu einer exponentiellen Verschlechterung der Lernleistung. Während andere Lernansätze wie Policy-Gradient-Methoden (die stark auf stochastische, auf der aktuellen Politik basierende Schätzungen setzen) diesen Effekt abmildern können, bleibt Q-Learning mit seiner bootstrapped TD-Zielgröße besonders anfällig. Eine erfolgversprechende Strategie zur Umgehung dieses Problems ist die sogenannte Horizontverkürzung. Hierbei werden die Vorhersageziele auf einen kürzeren Zeitraum beschränkt oder das Problem wird hierarchisch in mehrere Ebenen mit kürzeren Zeithorizonten unterteilt. Beispiele sind n-Step-Returns, bei denen anstatt nur eines einzigen Folgeschrittes Rückgaben über mehrere Schritte berechnet werden, oder hierarchische RL-Verfahren, die komplexe Aufgaben in überschaubare Subziele zerlegen.
Studien zeigen, dass solche Techniken die Skalierbarkeit von Q-Learning deutlich verbessern und selbst auf schwierigen Langzeitaufgaben eine deutliche Leistungssteigerung ermöglichen. Allerdings sind diese Methoden bislang nicht als die endgültige Lösung zu verstehen. Die Horizontverkürzung hilft, das Problem zu mildern, löst aber nicht die grundlegende Verzerrung. Es bleibt daher eine signifikante Forschungslücke bei der Entwicklung neuartiger Off-Policy-Algorithmen, die langfristige Abhängigkeiten ohne starke Akkumulation von Fehlern modellieren und lernen können. Blickt man in die Zukunft, gibt es mehrere vielversprechende Ansätze, die das skalierbare Off-Policy-Reinforcement-Learning revolutionieren könnten. Ein Kandidat ist die Integration von Modellbasiertem Lernen und On-Policy-Verfahren. Modellbasiertes RL basiert auf dem Erlernen eines Zustandsübergangsmodells der Umgebung, was eine daten- und recheneffiziente Simulation von Rollouts erlaubt.
Innerhalb dieser Modelle kann man dann On-Policy-Methoden einsetzen, um zuverlässige Entscheidungen zu treffen, ohne auf teure echte Datengenerierung angewiesen zu sein. Eine andere interessante Richtung beinhaltet alternative mathematische Formulierungen des RL-Problems, wie die lineare Programmierung (LP) oder quasimetric RL. Diese Ansätze verzichten auf die herkömmliche temporale Differenzlernung und verfolgen neue Wege bei der Wertfunktionabschätzung, was helfen könnte, den Bias direkt zu eliminieren. Darüber hinaus experimentieren Forschende mit Monte-Carlo-basierten Methoden und kontrastiven Lernparadigmen, die traditionell in anderen Bereichen erfolgreiche Skalierungseigenschaften gezeigt haben. Außerdem sind hierarchische RL-Modelle, inspiriert von Konzepten wie der kognitiven Planung und der Kettenstruktur von Ideen in großen Sprachmodellen, vielversprechend.
Sie könnten es ermöglichen, komplexe Aufgaben in rekursive, überschaubare Entscheidungsbäume zu zerlegen, um so die Herausforderungen langer Planungshorizonte zu überwinden. Zusammenfassend lässt sich festhalten, dass Q-Learning zwar ein mächtiges Werkzeug ist, doch seine Skalierbarkeit für komplexe, langzeitige RL-Aufgaben aktuell noch eingeschränkt ist. Die Akkumulation von Bias über längere Zeitspannen erschwert das Lernen effektiver Strategien stark. Trotz dieser Herausforderungen ist die Forschung in diesem Bereich weiterhin dynamisch und vielversprechend. Innovative Methoden, insbesondere solche, die Horizon-Effekte reduzieren oder komplett neue Lernziele verfolgen, könnten zukünftig neue Maßstäbe setzen. Dies könnte entscheidend sein, um reale Anwendungen, wie autonome Roboter, fortschrittliche digitale Assistenten oder komplexe Spielstrategien, effizienter und leistungsfähiger zu machen.
Die Reise hin zu einem wirklich skalierbaren Reinforcement Learning ist also noch nicht zu Ende. Die Herausforderung, eine robuste, effiziente Off-Policy-Methode zu finden, die ebenso gut skaliert wie aktuelle On-Policy-Algorithmen oder sogar besser, bleibt eine der spannendsten Forschungsfragen unserer Zeit. Forscherinnen und Forscher weltweit arbeiten daran, die Grenzen zu verschieben und neue Ansätze zu testen. Es lohnt sich, diese Entwicklungen genau zu beobachten, denn sie werden maßgeblich beeinflussen, wie Künstliche Intelligenz in den kommenden Jahren unser Leben und unsere Technologien prägen wird.