Veranstaltungen Bitcoin Start-ups und Risikokapital

Große Sprachmodelle gezielt anpassen: Möglichkeiten und Grenzen des Fine-Tunings auf eigene Daten

Erfahren Sie, wie große Sprachmodelle (LLMs) durch gezieltes Fine-Tuning auf eigene Daten, beispielsweise umfangreiche Codebasen, angepasst werden können. Der Artikel beleuchtet technische Herausforderungen, Alternativen und bewährte Methoden, um das Beste aus modernen KI-Modellen herauszuholen.

Große Sprachmodelle gezielt anpassen: Möglichkeiten und Grenzen des Fine-Tunings auf eigene Daten

In der Welt der künstlichen Intelligenz und des maschinellen Lernens gewinnen große Sprachmodelle, sogenannte Large Language Models (LLMs), zunehmend an Bedeutung. Sie sind in der Lage, natürliche Sprache zu verstehen, zu verarbeiten und selbstständig Texte zu generieren. Während sie ursprünglich auf enormen Mengen an allgemeiner Textdatensätze trainiert wurden, stellt sich die Frage, ob und wie man diese Modelle auf spezifische Daten, die man ihnen „merken“ möchte, feinjustieren kann. Besonders relevant wird dies für Entwickler, die etwa große Codebasen besitzen und ein KI-Modell möchten, das spezielles Wissen daraus abruft, ohne ständig den gesamten Code in einen Prompt einfügen zu müssen. Ein solches Vorgehen könnte viele Prozesse optimieren und den Zugang zu komplexen Informationen erleichtern. Doch wie lässt sich das in der Praxis umsetzen? Ist das Fine-Tuning von LLMs auf individuell gewünschte Daten ein gangbarer Weg, oder gibt es bessere Alternativen?

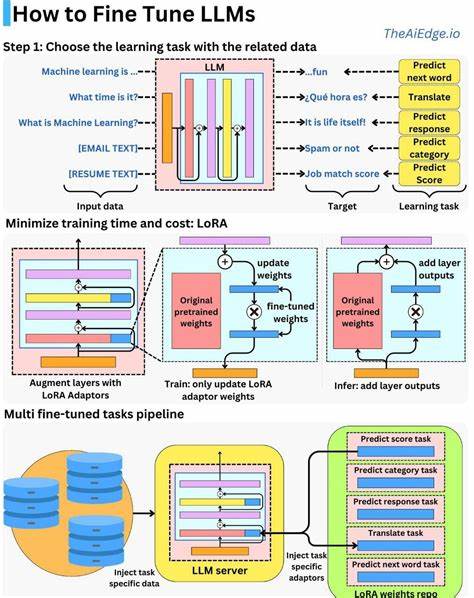
Das Grundprinzip des Fine-Tunings besteht darin, ein bereits vortrainiertes Sprachmodell auf einem kleineren, spezifischeren Datensatz weiter zu trainieren. Auf diese Weise lernt das Modell, sich besser an die Charakteristika der neuen Daten anzupassen und relevantere Antworten zu generieren. In Theorie klingt das vielversprechend. Praktisch ist es jedoch mit einigen Herausforderungen verbunden. Zum einen sind große Sprachmodelle extrem komplex und benötigen für ein erfolgreiches Fine-Tuning erhebliche Rechenressourcen. Dies betrifft vor allem neuere, leistungsfähigere Modelle wie GPT-3, GPT-4 oder deren Nachfolger. Die notwendigen GPUs und ausreichend Speicher sind nicht immer leicht zugänglich und können erhebliche Kosten verursachen. Außerdem erfordert das Fine-Tuning eine sorgfältige Kontrolle, um das Modell nicht durch Überanpassung zu degradieren oder seine allgemeinen Sprachfähigkeiten einzuschränken.

Ein weiteres Problem ergibt sich durch die Größe der Daten, die oft verarbeitet werden sollen, wie beispielsweise sehr umfangreiche Codebasen, die aus Millionen von Zeilen bestehen können. Soll der gesamte Code wirklich in das Modell integriert werden, würde dies enorme Mengen an Trainingsdaten bedeuten und den Prozess verkomplizieren. Auch die anschließende Leistung des Modells könnte beeinträchtigt werden, da es eventuell Schwierigkeiten hätte, zwischen allgemeinem Wissen und projektspezifischen Details zu unterscheiden. Eine pragmatischere Herangehensweise, die sich in der Praxis zunehmend etabliert, ist die Nutzung von sogenannten Retrieval-Augmented Generation (RAG) oder die Kombination von LLMs mit externen Wissensdatenbanken. Hierbei wird das Sprachmodell nicht direkt auf die spezifischen Daten trainiert, sondern arbeitet mit einem Such- oder Indexierungssystem zusammen.

Wenn eine Anfrage gestellt wird, durchsucht dieses System die Datenbank oder den Code, extrahiert relevante Informationen und fügt sie kontextuell in den Prompt an das Modell ein. So werden die Einschränkungen der Kontextlänge umgangen, da nicht der gesamte Datenbestand im Prompt enthalten sein muss, sondern nur die tatsächlich relevanten Ausschnitte. Das hat den großen Vorteil, dass die Modellparameter unangetastet bleiben und trotzdem gezielt auf hochspezifische Daten zugegriffen wird. Für Entwickler, die mit großen Codebasen arbeiten, bedeutet das, dass sie Ingestionswerkzeuge verwenden können, um den Quellcode in eine durchsuchbare Form zu bringen, wie zum Beispiel Vektor-Datenbanken auf Basis von Embeddings, die es ermöglichen, ähnlich zu bedeutende Textteile schnell zu finden. Diese Vektoren spiegeln die semantische Bedeutung der Daten wider und können dadurch sehr gezielt relevante Codeabschnitte anfragen.

Das Sprachmodell erhält dann – ohne selbst fine-getuned zu sein – die Möglichkeit, Wissen aus dem Projekt abzurufen, ohne die Beschränkung der Token-Limits im Prompt zu sprengen. Das Fine-Tuning bleibt dennoch in bestimmten Szenarien sehr wertvoll, etwa wenn es darum geht, ein Modell an den Sprachstil eines Unternehmens anzupassen, firmenspezifische Formulierungen einzuarbeiten oder auf eine begrenzte Domäne hoch spezialisiert zu werden, wo die Datenmenge überschaubar ist. Gerade hier lohnt sich die Investition in Rechenleistung und Zeit. Für sehr große oder ständig wachsende Datensätze ist die Kombination aus Retrieval und generativen Modellen allerdings effizienter und flexibler. Ein weiterer Aspekt ist die Verfügbarkeit von Open-Source-Modellen, die sich leichter selbst fine-tunen lassen als proprietäre. Mit Modellen wie LLaMA, Falcon oder Code LLMs, die eine offenere Lizenz besitzen, können mehr Freiräume für individuelles Training und Anpassungen genutzt werden.

Diese Modelle sind oft kleiner und benötigen weniger Ressourcen, bieten aber mit der richtigen Architektur und Trainings-Engine sehr gute Ergebnisse für spezifische Anwendungsfälle. Darüber hinaus entwickelten sich auch Methoden wie LoRA (Low-Rank Adaptation), die das Fine-Tuning effizienter und ressourcenschonender gestalten, indem sie nur ausgewählte Teilbereiche der Modelparameter modifizieren. So ist es möglich, auf kleineren Datenmengen und mit reduzierter Rechenpower Anpassungen vorzunehmen, ohne ein komplettes Retraining durchzuführen. Dies eröffnet insbesondere Startups und kleineren Teams Möglichkeiten, personalisierte Sprachmodelle zu erzeugen, die auf spezielle Daten abgestimmt sind. Zusammengefasst lässt sich festhalten, dass Fine-Tuning auf individuelle Daten grundsätzlich möglich und in gewissen Fällen auch sinnvoll ist, aber nicht immer die optimale Herangehensweise darstellt.

Gerade bei sehr großen Codebasen und komplexen Wissensbeständen ist der Einsatz hybrider Systeme aus Retrieval und generativer KI oft praktischer und nachhaltiger. Diese hybride Lösung skaliert besser, spart Ressourcen und ist flexibler im Umgang mit ständig wechselnden Dateninhalten. Die Zukunft wird vermutlich noch weitere Innovationen bringen, wie das «In-Context Learning» oder gar spezialisierte KI-Hardware, die das Fine-Tuning großer Modelle effizienter ermöglichen. Für den Moment sollten Entwickler jedoch sorgfältig abwägen, welche Anwendungsfälle ein direktes Fine-Tuning wirklich erfordern und wann externe Wissensdatenbanken, semantische Suche und Retrieval-basierte Systeme die bessere Wahl sind. Nur so lassen sich die Stärken der KI effizient für individuelle Bedürfnisse ausschöpfen.

OKX Partnerinhalte

Registrieren Sie sich bei OKX und erhalten Sie Ihren Willkommensbonus

OKX ist eine Plattform für Spot- und Futures-Handel, P2P-Tausch und Krypto-Sparpläne. Ein neues Konto über diesen Link eröffnet Zugang zum Willkommensbonus-Programm: bis zu 10.000 USDT für Ihre ersten Schritte an der Börse.

Konto erstellen und Bonus erhalten →

18+ · Partnerlink. Kryptowährungen sind volatil: Sie können Ihre Einlage verlieren.

Als Nächstes
Kryptowährungsbetrug in Mumbai: Wie ein Mann durch eine Heiratsvermittlung um 32 Lakh Rupien gebracht wurde
Samstag, 14. November 2026. Kryptowährungsbetrug in Mumbai: Wie ein Mann durch eine Heiratsvermittlung um 32 Lakh Rupien gebracht wurde

In einer zunehmend digitalisierten Welt, in der soziale Medien und Online-Plattformen unser tägliches Leben durchdringen, nehmen auch vielseitige Betrugsmaschen rasant zu. Besonders erschreckend sind Fälle, in denen Menschen auf scheinbar seriösen Plattformen wie Heiratsvermittlungen betrogen werden.

US-Mexiko Stahlzölle im Fokus: Auswirkungen auf Nucor und den S&P 500 am 11. Juni 2025
Samstag, 14. November 2026. US-Mexiko Stahlzölle im Fokus: Auswirkungen auf Nucor und den S&P 500 am 11. Juni 2025

Am 11. Juni 2025 gaben die Entwicklungen rund um die Handelsbeziehungen der USA und Mexikos dem Aktienmarkt eine neue Dynamik, wobei insbesondere die Stahlsektor-Aktien unter Druck gerieten.

VidGen: Die Zukunft der KI-generierten Kurzvideos für kreative Inhalte
Samstag, 14. November 2026. VidGen: Die Zukunft der KI-generierten Kurzvideos für kreative Inhalte

In der heutigen digitalen Welt sind kurze, fesselnde Videos zu einem zentralen Bestandteil der Online-Kommunikation geworden. Plattformen wie TikTok, Instagram Reels und YouTube Shorts haben die Art und Weise verändert, wie Menschen Inhalte konsumieren, was den Bedarf an kreativen, prägnanten und ansprechenden Videoinhalten stark erhöht.

Meta Platforms setzt große Hoffnungen auf Künstliche Allgemeine Intelligenz mit milliardenschwerer Investition und neuem KI-Expertenteam
Samstag, 14. November 2026. Meta Platforms setzt große Hoffnungen auf Künstliche Allgemeine Intelligenz mit milliardenschwerer Investition und neuem KI-Expertenteam

Meta Platforms, eines der weltweit führenden Technologieunternehmen, geht einen bedeutenden Schritt in Richtung Zukunft und investiert massiv in die Entwicklung der Künstlichen Allgemeinen Intelligenz (AGI). CEO Mark Zuckerberg hat sich das ehrgeizige Ziel gesetzt, Maschinen zu entwickeln, die in der Lage sind, menschliche Fähigkeiten nicht nur zu reproduzieren, sondern sogar zu übertreffen.

Altcoin-Rallye 2025: Wie Krypto-ETFs den Markt revolutionieren könnten
Samstag, 14. November 2026. Altcoin-Rallye 2025: Wie Krypto-ETFs den Markt revolutionieren könnten

Der Kryptomarkt befindet sich in einem ständigen Wandel, geprägt von technologischen Innovationen, regulatorischen Entwicklungen und geopolitischen Einflüssen. Inmitten der aktuellen Marktphase, die von leichter Schwäche bei Bitcoin und Verlusten bei vielen Altcoins gekennzeichnet ist, zeichnen sich bereits vielversprechende Anzeichen für eine mögliche Altcoin-Rallye ab.

Warum Wetter-Apps im Frühsommer oft ungenau sind: Ein Blick hinter die Kulissen der Vorhersagen
Samstag, 14. November 2026. Warum Wetter-Apps im Frühsommer oft ungenau sind: Ein Blick hinter die Kulissen der Vorhersagen

Das Wetter ist ein Thema, das uns alle täglich begleitet und beeinflusst. Besonders im Frühsommer, wenn die Luft warm wird und die Atmosphäre instabiler, scheinen viele Wetter-Apps oft nicht die Realität widerzuspiegeln.

Bunge steht kurz vor Zustimmung Chinas für 8,2 Milliarden Dollar schwere Viterra-Übernahme
Samstag, 14. November 2026. Bunge steht kurz vor Zustimmung Chinas für 8,2 Milliarden Dollar schwere Viterra-Übernahme

Die geplante Übernahme des kanadischen Agrarhandelsunternehmens Viterra durch den US-amerikanischen Branchenriesen Bunge steht kurz vor einem entscheidenden Wendepunkt. Chinesische Regulierungsbehörden sollen in den kommenden Tagen ihr Urteil zur rund 8,2 Milliarden US-Dollar schweren Fusion fällen, wie mehrere Quellen, darunter Bloomberg News, berichten.

Weitere Artikel zum Thema
Warum DOGE und SHIB trotz Elon Musks süßer Hunde-Posts weiter fallen
Freitag, 13. November 2026. Warum DOGE und SHIB trotz Elon Musks süßer Hunde-Posts weiter fallen

Im März 2025 sorgte Elon Musk erneut für Aufsehen, als er auf der Social-Media-Plattform X, früher bekannt als Twitter, ein Bild mit mehreren Hunden und Münzen postete. Darunter befand sich auch eine Darstellung des Shiba Inu, der ikonische Hund, der als Vorlage für diverse Meme-Coins wie Dogecoin (DOGE) und Shiba Inu (SHIB) dient.

Mattel pausiert Hot Wheels Virtual Garage NFTs: Was steckt hinter der Entscheidung?
Samstag, 14. November 2026. Mattel pausiert Hot Wheels Virtual Garage NFTs: Was steckt hinter der Entscheidung?

Mattel, einer der weltweit führenden Spielzeughersteller, hat kürzlich bekannt gegeben, dass das Projekt Hot Wheels Virtual Garage NFTs vorerst eingestellt wird. Diese Ankündigung sorgt in der Sammler- und NFT-Community für Aufsehen, denn sie zeigt, wie dynamisch und herausfordernd der Markt für digitale Sammlerstücke sein kann – insbesondere wenn traditionelle Marken wie Hot Wheels ihre Präsenz im Krypto- und NFT-Bereich ausbauen.

Bitcoin steht vor Risiko eines Rückgangs auf 75.000 USD bei Bruch der 83.000 USD Unterstützung – Technische Analyse im Fokus
Samstag, 14. November 2026. Bitcoin steht vor Risiko eines Rückgangs auf 75.000 USD bei Bruch der 83.000 USD Unterstützung – Technische Analyse im Fokus

Bitcoin, die bekannteste Kryptowährung weltweit, zeigt derzeit Anzeichen von erhöhter Volatilität und Unsicherheit auf dem Markt. Nach einer starken Erholungsphase in den vergangenen Wochen ist der Kurs bei etwa 86.

KI-Agenten: Weniger Hype, Mehr Verlässlichkeit für den echten Mehrwert
Samstag, 14. November 2026. KI-Agenten: Weniger Hype, Mehr Verlässlichkeit für den echten Mehrwert

Im Jahr 2025 werden KI-Agenten von vielen als die nächste große Revolution in der Technologiebranche gefeiert. Die Fortschritte bei günstigeren Modellen, innovativen Werkzeugen wie Multi-Component-Processing (MCP), Gedächtnis-Funktionalitäten und Rapid Automated Generation (RAG) sowie zehnfach gesteigerte Inferenzgeschwindigkeiten lassen die Erwartungen an KI-Agenten enorm steigen.
