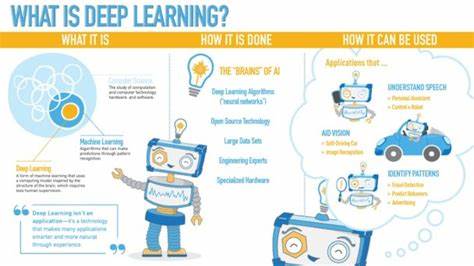
Deep Learning hat in den letzten Jahren eine wahre Revolution in vielen Bereichen der Technik und Wissenschaft ausgelöst. Modelle, die auf künstlichen neuronalen Netzen basieren, übertreffen oft traditionelle Algorithmen in der Bild-, Sprach- und Textverarbeitung sowie in zahlreichen weiteren Anwendungen. Gleichzeitig gibt es aus statistischer Sicht viele Gründe, warum diese Ansätze gar nicht funktionieren sollten. Dies führt zu einer tiefen Verwirrung in der Gemeinschaft der Statistiker und Mathematiker: Wie kann ein Verfahren, das scheinbar gegen alle etablierten Prinzipien der Statistik verstößt, derart beeindruckende Resultate liefern? Ein detaillierter Blick auf Intuitionen und zugrundeliegende Mechanismen schafft Klarheit und eröffnet neue Perspektiven für das Verständnis von Deep Learning. Zu Beginn ist es wichtig, das Wesen der Parameter in Deep-Learning-Modellen zu verstehen.
Modelle mit Millionen oder sogar Milliarden von Parametern entstehen durch die Kombination zahlreicher Gewichtungen und Verbindungen innerhalb der Netzwerke. Trotz der scheinbar enormen Komplexität eröffnen hochdimensionale Räume ungewöhnliche Eigenschaften: In solchen Räumen sind alle Punkte relativ nah zueinander. Dies widerspricht unserem gewohnten Verständnis aus dreidimensionalen Alltagserfahrungen, denn in hohen Dimensionen verschwimmen die Differenzen zwischen Einzelelementen. Die Statistik gibt hier eine Erklärung: Wenn wir uns Parameter als Zufallsvariablen vorstellen, dann führt der zentrale Grenzwertsatz dazu, dass die Abstände zwischen verschiedenen Parametervektoren um einen engen Mittelwert gruppiert sind. Einfach gesagt bedeutet dies, dass ein zufälliger Startpunkt bei der Optimierung bereits in der Nähe eines guten Parametersets liegen kann. Ein weiterer faszinierender Aspekt ist die vermeintliche Abwesenheit von lokalen Optima in hochdimensionalen Funktionsräumen.
Für viele ist die Vorstellung der Optimierung mit Gradientenabstieg stark von der Existenz anziehender Minima geprägt, in denen Modelle „steckenbleiben“ könnten. Doch in Netzwerken mit Milliarden von Parametern ist das Risiko, an einem solchen lokalen Minimum hängen zu bleiben, verschwindend gering. Die enorme Anzahl von Dimensionen ermöglicht es, praktisch immer einen Fluchtweg zu finden, wodurch sogenannte Wände, die in kleinen Dimensionen unüberwindbar scheinen, in hohen Dimensionen irrelevant werden. Diese Einsicht entkräftet lang gehegte Ängste über schlechte Optimierungslandschaften und unbewegliche Sackgassen. Eine weitere wichtige Betrachtung betrifft den Umgang des Optimierungsalgorithmus mit ähnlich bewerteten Parametern. Deep Learning operiert oft in zwei verschiedenen Trainingsregimen: Im traditionellen Ansatz wird das Modell auf eine bestimmte Datengröße trainiert und nach Erreichen eines optischen Punktes durch frühes Stoppen vor Überanpassung bewahrt.
Hier kommt die Intuition zum Tragen, dass bei beinahe korrelierten Eingaben die Gradienten am Anfang sehr ähnlich sind, später jedoch auseinanderdriften und in Rauschen übergehen. Dieses Rauschen ist ein Hinweis auf Überanpassung, weshalb frühes Stoppen als eine elegante Form der Regularisierung fungiert. Im Gegensatz dazu gibt es das sogenannte „double descent“-Phänomen, das in der Forschung verstärkt Beachtung findet. Hier wird das Modell derart groß dimensioniert, dass es problemlos die Trainingsdaten zu Null-Fehlern anpasst. Dies wäre nach klassischer Sichtweise ein garantierter Weg zur Überanpassung und damit zu schlechter Verallgemeinerung. Doch stattdessen verbessert sich die Generalisierung erneut, was den Begriff der zweiten Abstiegsphase erklärt.
Auch hier gibt es eine zugrundeliegende rationale Erklärung: Nach dem Erlernen grundsätzlicher Merkmale in den unteren Schichten des Netzes gilt es, eine Durchschnittsrepräsentation aller möglichen guten Modelle in den oberen Schichten zu finden. Gradient-Based-Methoden tendieren dazu, solche gleichwertigen Modelle gleich zu gewichten, wodurch das Modell eine natürliche Form der Verallgemeinerung erfährt. Mit diesen Erkenntnissen wird klar, warum größere und tiefere Modelle oft bessere Resultate erzielen – selbst wenn die Menge an Trainingsdaten nicht zunimmt oder sogar kleiner wird. Die immense Anzahl an Parametern eröffnet eine nahezu unerschöpfliche Vielfalt von Modellen, die in verschiedenen Kombinationen ähnlich gut performen. Die Trainingsverfahren finden nicht nur einen einzelnen Lösungsweg, sondern einen Durchschnitt all dieser guten Funktionen, was zu verbesserter Robustheit und Generalisierung führt.
Gleichzeitig wird durch frühes Stoppen und Suche nach stabilen Merkmalen verhindert, dass das Modell in reine Rauschanpassung abdriftet. Diese neue Perspektive wirft auch Fragen auf, wie bisherige theoretische Ansätze zur Analyse neuronaler Netze weiterentwickelt werden sollten. Klassische Konzepte wie das Auffinden von Minima oder der Fokus auf das Verhalten um konvexe Funktionsbereiche scheinen nicht hinreichend, um das Verhalten großer Modelle realistisch abzubilden. Stattdessen müsste der Fokus auf das gesamte Verhalten weit entfernt von Minima gelegt werden. Ein Optimierungsalgorithmus sollte vielmehr als eine Art Prioritätswarteschlange verstanden werden, der Schritt für Schritt jene Merkmale lernt, die am wichtigsten für Generalisierung sind. Die Herausforderung besteht darin, dass der Algorithmus besonders gut darin ist, die relevanten Aspekte zuerst zu erfassen, während die unnötigen oder schädlichen Merkmale erst später während des Trainings auftauchen.
Genau hier trennt sich eine gute Optimierung vom schlechten Training. Dieses Verständnis erklärt auch Phänomene wie das erfolgreiche Knowledge Distillation, bei dem ein kleineres „Student“ Modell von einem größeren „Teacher“ Modell lernt. Dabei werden nicht einfach nur Datenwerte kopiert, sondern die „guten“ Merkmale und Funktionsweisen des Lehrermodells übertragen, sodass der Student die wichtigen Zusammenhänge zuerst lernt und so insgesamt besser generalisiert. Es wird also nicht nur Wissen übertragen, sondern eine optimierte Reihenfolge des Lernens – eine direkte Folge der zugrundeliegenden Optimierungsdynamik. Insgesamt zeigt sich, dass Deep Learning trotz scheinbarer Widersprüche zu traditionellen statistischen Prinzipien ein ganz eigenes, förderliches Verhalten in hochdimensionalen Räumen und im Zusammenspiel von Optimierung und Modellkapazität an den Tag legt.
Diese Erkenntnisse helfen dabei, besser zu verstehen, warum größere und tiefere Modelle auch ohne zunehmende Datenmengen effektiv sind und warum Begriffe wie lokale Minima oder Overfitting durch Datenanpassung neu gedacht werden müssen. Für die Zukunft der Deep-Learning-Forschung ist es also essenziell, den Fokus weg von rein konzeptionellen Ideen wie perfekten Minima hin zu einer ganzheitlicheren Analyse des Trainingsprozesses zu verschieben. Anstatt zu behaupten, dass die Optimierung in der Nähe von Minima stattfindet, muss die realistische dynamische Bewegung im riesigen Parameterraum untersucht werden. Nur so können wir besser verstehen, wodurch Trainingsverfahren lernen und wie sie zu immer leistungsfähigeren Modellen führen. Die Faszination des Deep Learning liegt also nicht nur in seiner praktischen Effektivität, sondern auch in den überraschenden mathematischen und statistischen Eigenschaften, die in großen und tiefen Netzwerken zum Tragen kommen.
Die Kombination aus hochdimensionalen Geometrien, optimierungsdynamischen Effekten und cleverem Umgang mit Trainingsdaten macht Deep Learning zu einem der spannendsten Gebiete der modernen Forschung – mit Potenzial weit über die heutige Technologie hinaus.