ICO-Token-Verkäufe Analyse des Kryptomarktes Juristische Nachrichten

Generalisierungsbias bei der Zusammenfassung wissenschaftlicher Forschung durch große Sprachmodelle: Chancen und Herausforderungen

Ein umfassender Einblick in die Problematik des Generalisierungsbias bei großen Sprachmodellen und deren Auswirkungen auf die Zusammenfassung wissenschaftlicher Forschung. Erfahren Sie, welche Herausforderungen bestehen, wie diese Bias entstehen und welche Lösungsansätze zur Verbesserung der Genauigkeit und Zuverlässigkeit beitragen können.

Generalisierungsbias bei der Zusammenfassung wissenschaftlicher Forschung durch große Sprachmodelle: Chancen und Herausforderungen

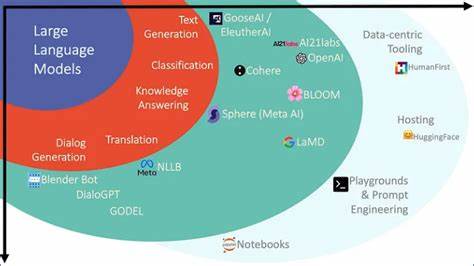
Die rasante Entwicklung großer Sprachmodelle hat die Art und Weise revolutioniert, wie wissenschaftliche Forschung zusammengefasst und vermittelt wird. Diese Modelle sind in der Lage, komplexe Texte zu analysieren und zu verdichten, sodass Forschende, Studierende und Interessierte schnell einen Überblick über umfangreiche wissenschaftliche Inhalte erhalten. Trotz dieser Fortschritte gibt es jedoch eine Herausforderung, die das Vertrauen und die Verlässlichkeit solcher Zusammenfassungen beeinträchtigt: der Generalisierungsbias. Generalisierungsbias bezeichnet eine systematische Verzerrung, die auftritt, wenn ein Modell bei der Verarbeitung und Zusammenfassung von Daten zu stark vereinfachte oder vermeintlich „allgemeingültige“ Aussagen trifft. Statt die vielfältigen Nuancen und Besonderheiten der wissenschaftlichen Forschung angemessen abzubilden, neigen Sprachmodelle dazu, wichtige Details zu verallgemeinern oder sogar falsch darzustellen.

Dies kann zu Missverständnissen führen und im schlimmsten Fall die wissenschaftliche Integrität gefährden. Die Ursachen für Generalisierungsbias liegen vielfach im Training der Modelle begründet. Große Sprachmodelle werden auf riesigen Korpora aus unterschiedlichsten Texten trainiert. Dabei lernen sie, statistische Muster und Zusammenhänge zu erkennen, um Vorhersagen über den nächsten Textabschnitt zu treffen oder eine kohärente Zusammenfassung zu erstellen. Jedoch spiegeln diese Trainingsdaten nicht immer die Komplexität oder Spezifität wissenschaftlicher Diskurse wider. Ebenfalls werden Überschriften, Abstracts und Lehrbuchtexte mit Dokumenten vermischt, die weniger präzise oder fachlich differenziert sind. Dadurch entsteht eine Tendenz, Inhalte eher zu verallgemeinern, anstatt die feinen Details herauszuarbeiten. Die Folgen dieser Verzerrung sind besonders kritisch im wissenschaftlichen Kontext. Wissenschaft lebt von Genauigkeit und Differenzierung.

Fehlerhafte oder ungenaue Zusammenfassungen können nicht nur das Verständnis erschweren, sondern auch die Qualität weiterer Forschung beeinträchtigen, die auf diesen Zusammenfassungen aufbaut. Zudem gefährdet der Generalisierungsbias das Vertrauen in KI-gestützte Anwendungen, wenn Nutzer wiederholt auf unzuverlässige Informationen stoßen. Darüber hinaus hängt das Ausmaß dieses Bias maßgeblich von der Datenbasis und der Architektur des jeweiligen Modells ab. Modelle, die auf wenigen oder einseitigen Daten trainiert wurden, weisen besonders starke Generalisierungsfehler auf. Auch die Feinjustierung beziehungsweise das sogenannte „Fine-Tuning“ mit spezifischen wissenschaftlichen Fachtexten kann diese Verzerrung reduzieren, indem die Modelle ein besseres Verständnis für die Fachterminologie und Forschungskontexte entwickeln. Eine Schlüsselrolle spielen auch die Methoden der Textzusammenfassung selbst. Es gibt extraktive und abstraktive Verfahren.

Während extraktive Zusammenfassungen Textpassagen direkt aus dem Originaldokument übernehmen und daher tendenziell genauer die Inhalte repräsentieren, generieren abstraktive Zusammenfassungen komplette Neuentwürfe, die mit mehr kreativer Freiheit operieren. Diese Freiheit birgt die Gefahr, dass Modelle „halluzinieren“ und Inhalte vermeintlich zusammenfassen, ohne tatsächlich die zugrundeliegenden wissenschaftlichen Fakten exakt wiederzugeben. Somit ist der Generalisierungsbias insbesondere bei abstraktiven Verfahren ein relevantes Problem. Um die Zuverlässigkeit großer Sprachmodelle in der wissenschaftlichen Zusammenfassung zu erhöhen, arbeiten Forscher an verschiedenen Lösungsansätzen. Eine Strategie besteht darin, die Trainingsdaten spezifisch auf wissenschaftliche Texte zu konzentrieren und dabei die Vielfalt der Disziplinen und Publikationsformate abzubilden.

Dies hilft, ein umfassenderes Verständnis der Forschungsthemen zu erzeugen und die Generalisierung auf unnötige Standardformulierungen zu reduzieren. Darüber hinaus gewinnt das Einbinden von Expert*innenwissen an Bedeutung. Hierbei werden Modelle mit zusätzlichem Feedback von Fachleuten trainiert, sodass sie lernen, auf wichtige Details besonders zu achten und voreilige Vereinfachungen zu vermeiden. Dieses menschliche Korrektiv kann helfen, die Qualität der Ausgaben wesentlich zu verbessern. Technologische Fortschritte in der Modellarchitektur spielen ebenfalls eine Rolle. Neuere Modelle verfügen über Mechanismen, die es erlauben, explizite Verweise auf Quellen herzustellen oder Unsicherheiten in der Darstellung besser zu kommunizieren. Solche Funktionen können helfen, potenzielle Fehler transparent zu machen und den Nutzer darauf hinzuweisen, wann eine Aussage mit Vorsicht zu genießen ist. Neben der technischen Optimierung ist auch die Sensibilisierung der Nutzer wichtig.

Nutzer sollten wissen, dass Zusammenfassungen von großen Sprachmodellen nicht als alleinige Wahrheit gelten sollten. Wissenschaftliche Texte mit eigenen kritischen Augen zu lesen, bleibt unerlässlich und sorgt dafür, dass Fehler oder Verzerrungen schnell erkannt werden können. Ein interessantes Forschungsfeld ist auch die Entwicklung von Bewertungsmethoden, die Generalisierungsbias explizit messen und quantifizieren. Über sogenannte Bias-Metriken können Entwickler besser verstehen, wie stark Modelle vereinfachen und an welchen Stellen die Gefahr von Fehlinformationen besonders hoch ist. Diese Erkenntnisse ermöglichen gezielte Anpassungen und verschärfen zugleich die Transparenz der KI-gestützten Prozesse. Die Herausforderungen, die durch Generalisierungsbias bei der Zusammenfassung wissenschaftlicher Forschung entstehen, sind komplex und erfordern eine interdisziplinäre Herangehensweise.

Informatiker*innen, Linguist*innen, Fachwissenschaftler*innen und Nutzer*innen müssen gemeinsam daran arbeiten, um ein Gleichgewicht zwischen Nützlichkeit und Genauigkeit zu schaffen. Nur so lässt sich das volle Potenzial großer Sprachmodelle ausschöpfen, ohne die wissenschaftliche Qualität zu gefährden. Die Zukunft zeigt vielversprechende Perspektiven. Durch kontinuierliche Verbesserung der Trainingsdaten und Algorithmen, gekoppelt mit einer stärkeren Einbindung menschlicher Expertise, können große Sprachmodelle immer präzisere und differenziertere Zusammenfassungen erstellen. Solche Fortschritte sind essentiell, um die wachsende Flut an wissenschaftlicher Information beherrschbar zu machen und den Erkenntnisgewinn in vielen Disziplinen zu beschleunigen. Zusammenfassend lässt sich sagen, dass Generalisierungsbias ein bedeutendes Hindernis für die Zuverlässigkeit von KI-gestützter wissenschaftlicher Zusammenfassung darstellt.

Doch mit gezielten Maßnahmen und einem breiten Bewusstsein für die Problematik können diese Verzerrungen reduziert werden. Damit ermöglichen große Sprachmodelle künftig nicht nur eine effektivere Wissensvermittlung, sondern tragen auch zur Steigerung der Qualität und Integrität der wissenschaftlichen Kommunikation bei.
OKX Partnerinhalte

Registrieren Sie sich bei OKX und erhalten Sie Ihren Willkommensbonus

OKX ist eine Plattform für Spot- und Futures-Handel, P2P-Tausch und Krypto-Sparpläne. Ein neues Konto über diesen Link eröffnet Zugang zum Willkommensbonus-Programm: bis zu 10.000 USDT für Ihre ersten Schritte an der Börse.

Konto erstellen und Bonus erhalten →

18+ · Partnerlink. Kryptowährungen sind volatil: Sie können Ihre Einlage verlieren.

Als Nächstes
Gedankenlesen im Gerichtssaal: Die umstrittene Forensik-Technologie BEOS aus Indien
Samstag, 14. November 2026. Gedankenlesen im Gerichtssaal: Die umstrittene Forensik-Technologie BEOS aus Indien

In den letzten zwei Jahrzehnten hat Indien eine bemerkenswerte Entwicklung im Bereich der forensischen Technologien erlebt. Unter ihnen sticht eine Methode besonders hervor: die Brain Electrical Oscillation Signature Profiling, kurz BEOS.

Coinbase im S&P 500: Eine neue Ära für Kryptowährungen und traditionelle Märkte
Samstag, 14. November 2026. Coinbase im S&P 500: Eine neue Ära für Kryptowährungen und traditionelle Märkte

Die jüngste Entscheidung, den Krypto-Handelsplatz Coinbase in den S&P 500 aufzunehmen, hat in der Finanzwelt für großes Aufsehen gesorgt. Coinbase wird damit zum ersten Unternehmen seiner Art, das in den renommierten Index einzieht, in dem bisher vor allem etablierte Branchenführer wie Apple oder Berkshire Hathaway vertreten sind.

Metaplanet erhöht Bitcoin-Bestand auf über 400 Millionen US-Dollar durch neuen Kauf im Wert von 28 Millionen US-Dollar
Samstag, 14. November 2026. Metaplanet erhöht Bitcoin-Bestand auf über 400 Millionen US-Dollar durch neuen Kauf im Wert von 28 Millionen US-Dollar

Der Kryptomarkt steht weiterhin im Fokus von Investoren und Unternehmen, die das Potenzial der digitalen Währungen erkennen. Ein bemerkenswertes Beispiel hierfür ist Metaplanet, das kürzlich seinen Bitcoin-Bestand durch einen neuen Kauf im Wert von 28 Millionen US-Dollar auf über 400 Millionen US-Dollar erhöht hat.

Binance revolutioniert Krypto-Asset-Management mit neuen 'Fund Accounts' für professionelle Anleger
Samstag, 14. November 2026. Binance revolutioniert Krypto-Asset-Management mit neuen 'Fund Accounts' für professionelle Anleger

Binance, die weltweit führende Kryptowährungsbörse, hat jüngst eine bedeutende Neuerung im Bereich des digitalen Asset-Managements vorgestellt: sogenannte „Fund Accounts“. Dieses neue Produkt richtet sich explizit an digitale Vermögensverwalter und ermöglicht ihnen, die Assets ihrer Investoren zu bündeln und zu verwalten, wobei der gesamte Prozess in vielerlei Hinsicht dem traditionellen Finanzhandel ähnelt.

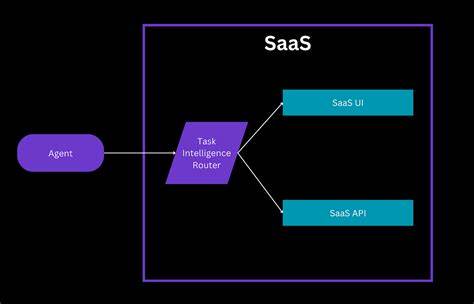
Revolution der KI-Agenten: Ist das traditionelle SaaS-Modell am Ende?
Samstag, 14. November 2026. Revolution der KI-Agenten: Ist das traditionelle SaaS-Modell am Ende?

Die Welt der Software as a Service, kurz SaaS, hat in den letzten Jahren einen beispiellosen Aufschwung erlebt. Unternehmen und Entwickler setzten zunehmend auf cloudbasierte Anwendungen, die ohne aufwendige lokale Installation zugänglich sind.

Kelloggs Mathematischer Fehler: Wie eine simple Rechnung zu großen Folgen führte
Samstag, 14. November 2026. Kelloggs Mathematischer Fehler: Wie eine simple Rechnung zu großen Folgen führte

Die Geschichte von Kellogg's mathematischem Fehler ist ein faszinierendes Beispiel dafür, wie selbst große und etablierte Unternehmen durch einen scheinbar kleinen Fehler in der Mathematik herausgefordert werden können. Während Kellogg's vor allem für seine innovativen Frühstücksprodukte und seine marktbeherrschende Stellung bekannt ist, zeigt dieser Vorfall, wie essenziell Genauigkeit und Sorgfalt in jedem Aspekt eines Unternehmens sind.

BlackRock und Fidelity verstärken Krypto-Investitionen: Bitcoin-ETFs verzeichnen Rekordzuflüsse von 41,489 Milliarden Dollar
Samstag, 14. November 2026. BlackRock und Fidelity verstärken Krypto-Investitionen: Bitcoin-ETFs verzeichnen Rekordzuflüsse von 41,489 Milliarden Dollar

In den letzten Jahren hat sich der Kryptowährungsmarkt von einer vorwiegend von Privatanlegern getriebenen Nische zu einem immer wichtiger werdenden Sektor unter institutionellen Investoren entwickelt. Ein besonders bemerkenswerter Trend zeigt sich aktuell im deutlichen Anstieg der Investitionen in Bitcoin Exchange Traded Funds (ETFs), wobei führende Finanzinstitutionen wie BlackRock und Fidelity eine Schlüsselrolle spielen.

Weitere Artikel zum Thema
Parra: Revolutionäre Parallelverarbeitung in JavaScript und TypeScript für moderne Webanwendungen
Samstag, 14. November 2026. Parra: Revolutionäre Parallelverarbeitung in JavaScript und TypeScript für moderne Webanwendungen

In der heutigen Ära der Webentwicklung sind performante und skalierbare Anwendungen unverzichtbar. JavaScript, die am weitesten verbreitete Sprache für Webanwendungen, bildet das Herzstück zahlreicher dynamischer und interaktiver Webseiten und Apps.

Trumps Exekutivbefehle und die Gründung der Kryptowährungs-Arbeitsgruppe: Ein Überblick
Freitag, 13. November 2026. Trumps Exekutivbefehle und die Gründung der Kryptowährungs-Arbeitsgruppe: Ein Überblick

Im Jahr 2023 wurden die Auswirkungen der Exekutivbefehle von Donald Trump auf die Welt der Kryptowährungen zunehmend klarer. Die Gründung der Kryptowährungs-Arbeitsgruppe steht im Mittelpunkt dieser Diskussion und hat enorme Bedeutung für die Regulierung und den Fortschritt digitaler Währungen in den USA und darüber hinaus.

Rostin Behnam: CFTC-Vorsitzender erklärt nur Bitcoin als Ware – Ethereum bleibt außen vor
Freitag, 13. November 2026. Rostin Behnam: CFTC-Vorsitzender erklärt nur Bitcoin als Ware – Ethereum bleibt außen vor

In einer kürzlich veröffentlichten Stellungnahme sorgte Rostin Behnam, der Vorsitzende der Commodity Futures Trading Commission (CFTC), für Aufsehen, als er erklärte, dass nur Bitcoin als Rohstoff anerkannt werden könne, während Ethereum und andere Kryptowährungen nicht in dieselbe Kategorie fallen. Diese Aussage wirft Fragen auf und spiegelt die anhaltende Debatte über die Regulierung von Kryptowährungen wider, die in den letzten Jahren immer lauter geworden ist.

Tether's $1 Milliarde USDT Mint auf Tron: Ein Vorzeichen für den Bull Run 2024?
Freitag, 13. November 2026. Tether's $1 Milliarde USDT Mint auf Tron: Ein Vorzeichen für den Bull Run 2024?

Die Krypto-Welt ist eine dynamische und oft unvorhersehbare Arena, in der Neuigkeiten und Entwicklungen innerhalb von Minuten die Kurslandschaft verändern können. Eine der jüngsten Entwicklungen, die für viel Aufsehen gesorgt hat, ist die Minting von 1 Milliarde USDT (Tether) auf der Tron-Blockkette.