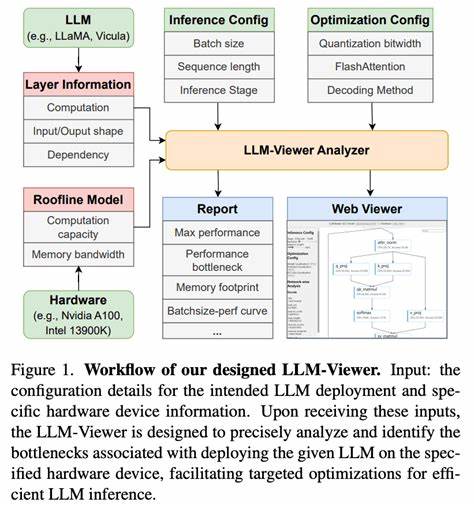
In der heutigen Welt der Künstlichen Intelligenz und vor allem im Bereich der Sprachmodelle (Large Language Models, LLMs) sind Geschwindigkeit und Effizienz zentrale Themen. Viele Entwickler und Unternehmen greifen bei der Nutzung von LLMs automatisch auf synchrone APIs zurück, um schnelle Antworten zu erhalten. Doch nicht alle Anwendungen profitieren von Echtzeitverarbeitung. Gerade bei großen Datenmengen, wo es nicht auf Sekunden oder Millisekunden ankommt, ist die Batch-Verarbeitung von LLM-Inferenz oft der intelligentere und wirtschaftlichere Weg. Die synchrone API ist für Anwendungen konzipiert, die eine direkte Interaktion erfordern. Beispiele dafür sind Chatbots, Kundenservice oder andere Echtzeitanwendungen, bei denen der Nutzer sofort eine Antwort erwartet. In solchen Fällen sind niedrige Latenzzeiten entscheidend. Die synchrone Verarbeitung ermöglicht eine Antwort innerhalb von Sekunden, oft sogar noch schneller.
Allerdings muss man sich bewusst sein, dass diese Art der Verarbeitung mit höheren Kosten pro Anfrage verbunden ist, da für niedrige Latenz ein ständig verfügbarer GPU-Fuhrpark betrieben werden muss. Im Gegensatz dazu steht die Batch-LLM-Inferenz, die eher mit OLAP-Systemen in der Datenverarbeitung vergleichbar ist. Diese Art der Verarbeitung ist asynchron und darauf ausgelegt, große Mengen von Daten effizient im Hintergrund zu bearbeiten. Die Antwortzeiten sind hierbei höher – das Ergebnis kann Minuten bis Stunden auf sich warten lassen. Dafür profitieren Unternehmen von drastischen Kosteneinsparungen, die Je nach Anbieter 50 bis 90 Prozent gegenüber der synchronen API betragen können. Diese Kostenersparnis entsteht durch eine optimierte Nutzung der Hardware-Ressourcen. Batch-API-Anbieter können GPU-Kapazitäten flexibler nutzen, indem sie nicht unmittelbar auf jede einzelne Anfrage reagieren müssen.
Sie können Rechenjobs sammeln, stapeln und dann in großen, parallelisierten Durchläufen bearbeiten. Dies führt zu einer deutlich höheren Auslastung der Hardware und somit zu geringeren Betriebskosten. Zudem umgehen Batch-APIs typische Probleme, die bei synchronen APIs auftreten – etwa das strikte Einhalten von Rate Limits oder die Notwendigkeit, mehrere API-Schlüssel zu verwalten und komplexe Retry-Mechanismen zu implementieren. Praktische Beispiele zeigen, dass Batch-LLM-Inferenz besonders bei Aufgaben wie der Klassifikation großer Textmengen, der Dokumentenverarbeitung, der Datenanreicherung oder auch der Inhaltsmoderation sinnvoll eingesetzt werden kann. In all diesen Bereichen sind direkte, sofortige Antworten nicht zwingend erforderlich. Stattdessen zählt die Fähigkeit, eine große Datenbasis zuverlässig und kostengünstig abzuarbeiten. Dadurch eröffnen sich für Unternehmen neue Möglichkeiten, KI-gestützte Prozesse zu skalieren, ohne das Budget zu sprengen.
Darüber hinaus reduziert Batch-Inferenz die technische Komplexität erheblich. Entwickler können sich auf die eigentliche Anwendungslogik konzentrieren, anstatt komplexe Pipelines zum Umgang mit Rate Limits und Fehlermanagement zu entwickeln. Typischerweise erfordert die synchrone, batchartige Bearbeitung von Daten eigene Programme, die mit Lastverteilung, zwischenzeitlichem Caching und Wiederholungslogik versehen sind. Diese Ansätze sind oft fragil und können Wochen dauern, bis der gesamte Batch erfolgreich durchlaufen ist. Batch-APIs vereinfachen diesen Prozess, denn sie übernehmen das komplette Management von Jobs, von der Einreihung über die parallele Verarbeitung bis hin zur Ergebnisbereitstellung im passenden Format, etwa JSONL oder CSV. Ein weiterer Punkt, der für Batch-LLM-Inferenz spricht, ist der Umgang mit offenen Modellen aus dem Open-Source-Bereich.
Im Gegensatz zu proprietären Echtzeit-APIs bieten spezialisierte Batch-Plattformen wie Sutro Zugriff auf leistungsstarke offene Modelle wie LLaMA oder Gemma, die sich ideal für weniger latenzkritische Workloads eignen. Open-Source-Modelle ermöglichen zudem mehr Flexibilität, weniger Anbieterbindung und bessere Kontrolle über die Daten, was für viele Unternehmen ein bedeutender Vorteil ist. Die strategische Entscheidung zwischen synchroner und asynchroner LLM-Verarbeitung hängt also maßgeblich vom Anwendungsfall ab. Wenn eine unmittelbare Antwort für Kunden oder Nutzer entscheidend ist, führt kaum ein Weg an synchronen APIs vorbei. Sobald jedoch größere Datenvolumina effizient verarbeitet werden sollen, empfiehlt sich ein Batch-Ansatz. Dies gilt insbesondere, wenn beispielsweise ganze Dokumentenarchive untersucht, Produktkataloge angereichert oder umfangreiche Content-Moderation automatisiert durchgeführt werden soll.
Batch-LLM-APIs eröffnen auch neue Möglichkeiten im Bereich Forschung und Wissenschaft. Simulationsläufe, Sentimentanalysen über große Textkorpora, Offline-Modellevaluationen oder die Erstellung synthetischer Trainingsdaten sind Anwendungsfälle, die von Batch-Verarbeitung stark profitieren. Indem es nicht auf die sofortige Verfügbarkeit von Ergebnissen ankommt, können Forscher und Entwickler große Mengen an Daten in einem überschaubaren Kostenrahmen analysieren und experimentieren. Ein wesentlicher Vorteil, der oft unterschätzt wird, ist die transparente Kontrolle und Überwachung von Batch-Jobs. Während synchrone APIs typischerweise nur eine unmittelbare Antwort liefern, bieten spezialisierte Batch-Plattformen eine Benutzeroberfläche oder Schnittstellen, in denen Jobs beobachtet, Fortschritte verfolgt und Ergebnisse übersichtlich geprüft werden können. Dies trägt zu einer verbesserten Fehlersuche und schnelleren Iterationen bei.
Die Zukunft der LLM-Inferenz wird vermutlich eine stärkere Integration beider Verarbeitungsarten sehen. Anwendungen, die Echtzeit-Latenz erfordern, können weiterhin auf synchrone APIs setzen, während eine Vielzahl von Hintergrundaufgaben durch Batch-APIs effizienter gestaltet wird. Unternehmen, die frühzeitig auf den Batch-Trend setzen, können ihre KI-Kosten nachhaltig senken und zugleich ihre Infrastruktur entlasten. Zusammenfassend lässt sich sagen, dass Batch-LLM-Inferenz keine Nische, sondern ein essenzielles Werkzeug in modernen KI-Architekturen darstellt. Wer große Datenmengen zu bewältigen hat und nicht auf die sofortige Verfügbarkeit von Ergebnissen angewiesen ist, fährt mit Batch-APIs deutlich besser – sowohl in Bezug auf Kosten als auch auf die Einfachheit der Implementierung und Wartung. Die Kombination aus Skalierbarkeit, Kosteneffizienz und einer stabileren Entwicklungsumgebung macht diesen Ansatz besonders für Unternehmen jeder Größe attraktiv.
Indem Entwickler und Entscheider ihre Anwendungen mit dem Blick auf Batch-Verarbeitung entwerfen, schaffen sie die Grundlage für belastbare und nachhaltige KI-Lösungen. Durch die Wahl des passenden API-Typs für den jeweiligen Use Case kann die gesamte Wertschöpfungskette effizienter gestaltet und Wettbewerbsvorteile genutzt werden. Batch-LLM-Inferenz ist somit nicht nur eine technische Alternative, sondern ein strategischer Hebel für erfolgreiche KI-Projekte im großen Maßstab.