Der zunehmende Erfolg großer Sprachmodelle (Large Language Models, LLMs) hat die Anforderungen an Hardware und Infrastruktur maßgeblich verändert. Besonders bei Modellen mit Milliarden oder sogar hundert Milliarden Parametern ist nicht nur die Rechenleistung entscheidend, sondern vor allem die Speicherbandbreite. Denn nur mit ausreichender Bandbreite lässt sich eine schnelle und effiziente Inferenz gewährleisten. Der Bau eines LLM-Rigs stellt daher eine Herausforderung dar, die beim Zusammenstellen der richtigen Komponenten, dem Umgang mit Hardware-Limitationen und der Optimierung von Software eine wichtige Rolle spielt. Eine der gängigsten Methoden, um die benötigte Speicherbandbreite zu erreichen, ist der Einsatz mehrerer GPUs mit hohem Grafikspeicher und sehr schnellem GDDR-Speicher. Solche Setups ermöglichen es, Modelle parallel und mit hoher Geschwindigkeit zu betreiben, sind aber mit einigen gravierenden Nachteilen verbunden.
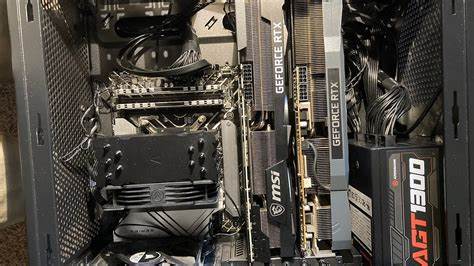
Dazu zählen der enorm hohe Stromverbrauch, der oft den Einbau leistungsfähiger Netzteile und komplexer Stromversorgungssysteme erfordert. Die Kühlung wird zu einem weiteren Problem: Ein Rig mit mehreren Hochleistungs-GPUs wird schnell zu einer lärmenden und hitzigen Angelegenheit, die umfangreiche Lüftungslösungen benötigt. Überdies stößt man hier schnell an physische Grenzen hinsichtlich verfügbarer PCIe-Lanes, Platz im Gehäuse und der Anordnung der Komponenten. Der Versuch, durch den Kauf einzelner, besonders speicherstarker Karten mit mehr VRAM die Anzahl der GPUs zu reduzieren, bedeutet meist sehr hohe Investitionen. Die Kosten für eine einzelne Karte mit 80 GB VRAM können weit über 15. 000 US-Dollar liegen, sodass die Anschaffung eines solchen Systems schnell kostspielig wird. Zudem ist es bei mehreren komplexen Modellen oft nicht möglich, alles vollständig in den Grafikspeicher zu laden, was zu einem sogenannten Out-of-Memory-Problem führt und die Performance ausbremst.
In der Praxis werden dadurch die Inferenzzeiten und die Funktionsvielfalt limitiert. Eine Alternative zu diesen klassischen GPU-Rigs ist die Nutzung von Apple-Hardware, insbesondere durch die einheitliche Speicherarchitektur (Unified Memory Architecture, UMA), die theoretisch hohe Geschwindigkeiten beim Zugriff auf den Speicher ermöglicht. Aufgrund von Software-Einschränkungen und mangelnder PCIe-Erweiterbarkeit sind Apple-basierte Systeme jedoch weniger flexibel und bieten in der Praxis oft nicht die erhoffte Performance. Zudem sind sie meist weniger gut skalierbar und schwer zu erweitern, was für den professionellen LLM-Betrieb ein großer Nachteil ist. Dazu kommt, dass die eigentliche Promptverarbeitung auf solchen Systemen nicht optimal läuft und es mitunter zu spürbaren Verzögerungen beim Start der Modellantworten kommt.
Eine dritte und äußerst interessante Variante ist der sogenannte CPuMAXx-Ansatz, bei dem auf leistungsstarke Multi-Socket-Server-CPUs wie die EPYC Genoa-Serie von AMD gesetzt wird. Diese CPUs bieten durch bis zu 24 DDR5-Speicherkanäle eine enorme Speicherbandbreite, die man sonst nur mit einem großen GPU-Rig erreicht. Ein Dual-Socket-System mit EPYC Genoa Prozessoren kann bis zu 920 GB/s Bandbreite im RAM erreichen. Diese Konstellation ermöglicht den Betrieb von sehr großen LLMs, ohne auf die Grenzen des Grafikspeichers angewiesen zu sein. Ein großer Vorteil ist hier die Flexibilität: Da CPUs sehr viele PCIe-Lanes bereitstellen, kann man beliebig GPUs und andere Hardware ergänzen, ohne Engpässe zu riskieren. Doch der Aufbau eines solchen NUMA-Systems (Non-Uniform Memory Access) ist nicht trivial. Man muss die Architektur verstehen und Software sowie Workloads darauf abstimmen, um den maximalen Durchsatz zu erzielen.
Bei falscher Konfiguration kann es zu erheblichen Performanceverlusten kommen. Allerdings bietet diese Lösung auch die Möglichkeit, eine sehr große Menge an RAM (bis zu mehreren Terabytes) zu verbauen, was bei GPU-Rigs kaum möglich ist. Zudem ist die allgemeine Rechenleistung für andere Aufgaben sehr hoch, sodass sich der Rechner als vielseitige Maschine etwa für das Hosten von virtuellen Maschinen, Entwicklung und weitere Workloads eignet. Im Vergleich zu GPU-Rigs ist der Strombedarf eines solchen Dual-Socket-EPYC-Systems deutlich moderater. Ein 1000-Watt-Netzteil reicht in der Regel aus, um die gesamte Infrastruktur zu versorgen, was die Betriebskosten senkt und die Kühlung erleichtert. Die Anordnung der Hardware erfordert allerdings größere Gehäuse, da CPU-Sockel und RAM-Module viel Platz in Anspruch nehmen.
Auch die Wärmeentwicklung ist geringer, aber dennoch nicht zu vernachlässigen – hier empfiehlt sich der Einsatz großvolumiger und langsamer Lüfter, um Geräuschentwicklung zu minimieren und zugleich die Temperaturen stabil zu halten. Im praktischen Betrieb zeigt sich, dass mit einem gut optimierten EPYC-basierten LLM-Rig Geschwindigkeiten von mehreren Billionen Tokens pro Sekunde (T/s) erreichbar sind. Modelle mit bis zu 405 Milliarden Parametern können hier quantisiert und im Kontext gespeichert nahezu in Echtzeit abgearbeitet werden. Für extrem große Mixture-of-Experts-Modelle (MoE), die oft Milliarden von Parametern besitzen und bei denen nur Teile des Modells zu einem Zeitpunkt aktiviert werden, sind solche Systeme sogar prädestiniert. Es ist möglich, diese gigantischen Modelle vollständig im Hauptspeicher zu halten, was viel flexibler ist als die GPU-VRAM-Begrenzung. Die praktische Folge: Die Inferenz läuft flüssiger und es fallen weniger Grenzen durch Speicherengpässe an.
Neben der Hardware sind auch Softwareoptimierungen entscheidend. Betriebssysteme mit aktuellen Linux-Kernel-Versionen, speziell ab 6. 6, schneiden auf EPYC-Servern besonders gut ab, da sie die gebotene Speicherbandbreite und CPU-Leistung bestmöglich nutzen. Wichtig ist außerdem die Deaktivierung von Transparent Hugepages, um Stabilität bei massivem Speicherbedarf zu garantieren. Die richtige BIOS-Konfiguration spielt ebenfalls eine Rolle. Hier empfiehlt sich der Betrieb im UEFI-Modus, wobei die xGMI-Verbindungen (die den Speicher zwischen den CPU-Sockeln verbinden) auf maximalem Speed laufen sollten. Überflüssige Geräte sollten deaktiviert werden, um PCIe-Lanes freizugeben und NUMA-Einstellungen sinnvoll anzupassen. Für den praktischen Betrieb mehrerer LLM-Instanzen bietet das NUMA-Setup weitere Vorteile. Es ist möglich, einzelne Anwendungen strikt an einzelne CPU-Sockel und deren zugehörigen RAM-Banks zu binden, sodass keine gegenseitigen Performance-Einbußen auftreten.
Dies ermöglicht Multi-User- und Multi-Agentenszenarien auf einer einzigen Maschine, ohne dass die einzelnen Prozesse um Ressourcen konkurrieren. Mit dem richtigen Einsatz von Tools wie numactl und spezieller Software-Unterstützung können so mehrere Modelle gleichzeitig mit guten Geschwindigkeiten betrieben werden. Obwohl das CPU-basierte Modell vor allem bei der Inferenz glänzt, wird das Training großer Modelle weiterhin der Domäne von GPU-Rigs vorbehalten bleiben. GPUs sind für parallele Rechenoperationen und das maschinelle Lernen nach wie vor deutlich effizienter. Dennoch erlaubt das CPuMAXx-Setup flexible Tests, schnelle Anpassungen an Quantisierungsverfahren und Experimente mit neuen Modellarchitekturen, ohne dass man einen größeren GPU-Cluster betreiben muss. Beim Zusammenstellen eines solchen Rigs ist die Wahl der Komponenten entscheidend.
Aktuelle Mutterbretter wie das Gigabyte MZ73-LM1 sind kompatibel mit EPYC Genoa-Prozessoren, bieten Zugang zu 24 DDR5-Steckplätzen und ausreichend PCIe-Slots für Erweiterungen. Für stabile Stromversorgung reicht ein gutes 1000-Watt-Netzteil aus. Die Kühlung sollte mit Server-4U-Kühlern oder vergleichbaren Modellen erfolgen, um den Raumtemperaturbereich bestmöglich zu halten. Für den Gebrauch ist Linux ein Muss, das es ermöglicht, mit modernen Compilern und optimierten Einstellungen die bestmögliche Performance herauszuholen. Erwähnenswert ist zudem, dass ein kleines, aber schnelles GPU-Modul, etwa eine 24-GB-Karte wie die Nvidia A5000, weiterhin sinnvoll bleibt. Dieses kann für Spezialaufgaben wie Text-to-Speech, Bildsynthese oder ähnliche gewichtete Processing-Schritte herangezogen werden. Der Hauptteil der LLM-Inferenz läuft dabei jedoch über den CPU-Komplex.
Zusammenfassend bietet der Bau eines LLM-Rigs mit Dual-EPYC-CPUs eine hervorragende Mischung aus hoher Speicherbandbreite, Flexibilität, guter Erweiterbarkeit und moderatem Stromverbrauch. Während GPU-Rigs bei reinen Trainingseinheiten unschlagbar bleiben, punkten CPU-Rigs bei der Nutzung und Anpassung großer Modelle in der Inferenz. Für Anwender mit vielseitigen Anforderungen, die neben LLMs noch weitere Workloads abdecken wollen, ist der CPuMAXx-Ansatz eine spannende und zukunftssichere Lösung. Wer auf der Suche nach der besten Leistung für große Sprachmodelle mit großer Kontextlänge ist, sollte diese moderne Architektur definitiv in Betracht ziehen.