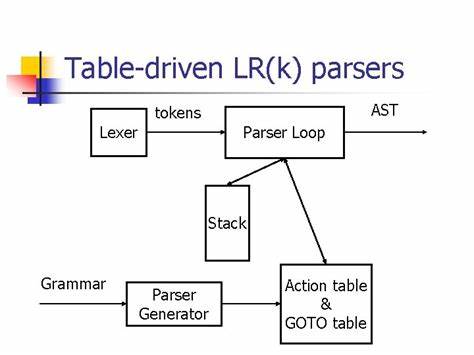
Lexer-Generatoren sind ein essenzieller Bestandteil moderner Programmierwerkzeuge und ermöglichen es Entwicklern, aus regulären Ausdrücken effiziente Scanner zu generieren, die Quellcode analysieren und in Tokens zerlegen. Dabei spielt die Geschwindigkeit der Verarbeitung eine Schlüsselrolle, insbesondere bei der Analyse großer Quelltexte. Ein zentrales Konzept zur Leistungsoptimierung in Lexer-Generatoren ist die Verwendung von Lookup-Tabellen, die den Vergleich eines Eingabezeichens mit einer Menge an erlaubten Zeichen stark beschleunigen. Doch während Lookup-Tabellen ihre Vorzüge haben, bringen sie auch bedeutende Herausforderungen mit sich – vor allem hinsichtlich des Speicherbedarfs und der Cache-Effizienz. Das innovative Konzept des Stapelns von Lookup-Tabellen bietet eine clevere Lösung, die sowohl Performance als auch Speicherverbrauch optimiert und die Grenzen klassischer Methoden überwindet.
Im Folgenden widmen wir uns ausführlich unterschiedlichen Ansätzen zur Optimierung von Lookup-Tabellen in Lexer-Generatoren und zeigen, wie dieses Verfahren neue Maßstäbe im Bereich der Compilerentwicklung setzen kann. Um das Problem und die Lösung besser zu verstehen, lohnt sich zunächst ein Blick auf klassische Methoden, mit denen Lexer nach Zeichenmustern suchen. Ein typisches Beispiel ist das Erkennen von Bezeichnern, etwa solcher, die Buchstaben, Ziffern und einige Sonderzeichen wie Unterstrich oder Dollarzeichen enthalten. In Programmiersprachen lässt sich dies durch reguläre Ausdrücke wie [a-zA-Z0-9_$]+ ausdrücken. Konventionell lassen sich diese Muster in einer Programmiersprache wie Rust relativ einfach mit Hilfe einer Match-Expression abbilden. Dabei prüft der Code für jedes Byte, ob es in den erlaubten Bereich fällt, und zählt, wie viele Zeichen hintereinander diese Bedingung erfüllen.
Diese Vorgehensweise ist zwar verständlich und ausreichend performant für kleinere Projekte oder manuell geschriebene Scanner. Aber sie ist nicht durchgängig optimal, wenn es darum geht, große Datenmengen schnell zu verarbeiten – oder wenn der Scanner automatisch durch einen Generator wie Logos erzeugt wird. Die Übersetzung in Maschinencode zeigt mehrere Schleifen und bedingte Verzweigungen, die zwar effizient sind, aber dennoch eine gewisse Anzahl an Befehlen und Sprüngen erfordern, was die CPU-Zyklen verbraucht. Um diese Einschränkungen zu umgehen, setzt die Compiler-Community vermehrt auf Lookup-Tabellen. Hierbei wird eine statisch definierte Tabelle mit 256 Einträgen für jeden möglichen Byte-Wert angelegt. Jeder Eintrag enthält ein Boolean, das ausdrückt, ob das jeweilige Byte zum Muster gehört oder nicht.
Anstatt also mit einer Match-Expression zu vergleichen, indexiert der Scanner direkt in dieser Tabelle – was einer einzigen Speicherzugriffsoperation entspricht und somit oft schneller verarbeitet werden kann. Moderne Compiler optimieren diese Zugriffe weiter so, dass keine Bounds-Prüfung auf das Array notwendig ist, wodurch der Overhead weiter sinkt. Die Vorteile liegen auf der Hand: Weniger Instruktionen, reduzierte Verzweigungen und somit ein klarer Gewinn in der Laufzeit. Dennoch ist diese Methode nicht frei von Nachteilen. Die Nutzung von statischen Lookup-Tabellen addiert zusätzlichen Speicherverbrauch in der Binary, konkret jeweils 256 Bytes pro Tabelle. Dies ist besonders kritisch in Umgebungen mit begrenztem Cache, denn L1-Cache-Größen im Prozessor sind klein, und diese Tabellen können so schnell den Cache füllen und dadurch Cache-Misses verursachen, die das Gegenteil der gewünschten Beschleunigung bewirken können.
Angesichts dieser Herausforderungen stellten Entwickler die Frage: Wie lässt sich der Speicherbedarf einer Lookup-Tabelle reduzieren, ohne die Geschwindigkeit einzubüßen? Eine Möglichkeit liegt in sogenannter „Packed Bitset“-Repräsentation. Dabei werden nicht 256 einzelne Bytes verwendet, sondern nur 256 Bits. Das entspricht einer Reduktion des Speicherbedarfs um den Faktor acht. In der Praxis realisiert man dies häufig als Array von vier 64-Bit-Werten, wobei jedes Bit ein Byte repräsentiert. Abfrage und Setzung eines Bits erfordern nur ein bisschen mehr Rechenaufwand, der durch spezielle CPU-Instruktionen schnell ausgeführt wird. Diese Variante belegt zwar weniger Speicher und sollte theoretisch genauso schnell sein, doch die Realität ist komplizierter. Das Erzeugen zusätzlicher Rechenoperationen, um das korrekte Bit zu extrahieren und zu testen, führt zu mehr Instruktionen im Hot-Loop.
Experimente zeigten, dass die Geschwindigkeit kaum gesteigert wird und in manchen Fällen nicht schneller ist als die herkömmliche Match-Lösung. Zudem ändert sich an der Tatsache nichts, dass jede einzelne Tabelle an sich isoliert verwendet wird – was bei vielen Mustern schnell zu einem Speicherfresser wird. An diesem Punkt setzt die innovative Idee des Stapelns von Lookup-Tabellen an. Die Kernaussage: Statt pro Muster eine eigene Tabelle mit 256 Bytes zu verwenden, werden mehrere Muster in einer einzigen Tabelle gebündelt. Dies gelingt, indem man jedem Muster ein Bit in jedem Byte zuweist. Auf diese Weise kann eine einzelne 256-Byte-Tabelle beispielsweise acht Muster gleichzeitig kodieren, indem sie je ein Bit pro Byte nutzt. So lassen sich beliebig viele Tabellen übereinanderlegen, ohne dass sich der Speicherbedarf multipliziert. Technisch erfolgt dies durch eine Kombination von Bitoperationen.
Um zu prüfen, ob ein bestimmtes Byte dem Muster entspricht, wird das jeweilige Byte aus der kombinierten Tabelle geladen, und mit einer Bitmaske geprüft, ob das korrekte Bit gesetzt ist. Dieser einfache Test ist effizient und lässt sich durch moderne Prozessor-Instruktionen wie TEST oder BT komplett ohne Vergleichsinstruktionen oder Sprünge realisieren. Die resultierende Assembly ist minimalistischer und einfacher als bei den meisten alternativen Ansätzen. Welche Vorteile bringt dieses Verfahren konkret mit sich? Zunächst die deutlich bessere Nutzung von CPU-Caches. Da mehrere Muster zusammen in einer einzigen Tabelle gespeichert sind, erhöht sich die Wahrscheinlichkeit, dass diese Tabelle komplett im L1-Cache verbleibt – im Gegensatz zu mehreren separaten Tabellen, die um begrenzten Speicherplatz konkurrieren. Dadurch sinken Cache-Misses, was eine spürbare Geschwindigkeitssteigerung bewirkt. Zudem wird der Code übersichtlicher und leichter wartbar.
Anstatt zahlreiche einzelne Lookup-Tabellen zu verwalten, sind alle Informationen zentral und konsolidiert vorhanden. Für Lexer-Generatoren wie Logos bedeutet dies eine Reduzierung der Komplexität im generierten Code und eine verbesserte Performance. Benchmarks weisen eine Steigerung der Verarbeitungsgeschwindigkeit um mehrere Prozentpunkte aus, was angesichts der oft millionenfachen Ausführung in großen Projekten eine signifikante Zeitersparnis ist. Die Herausforderung bei der Implementierung liegt vor allem im organisatorischen Aufwand der Codegenerierung und der korrekten Verwaltung der Bitmasken. Da das Verfahren von der Zugriffslogik profitiert, muss die prozessorgerechte Verteilung und Prüfung der Bits exakt erfolgen. Trotzdem lässt sich dieser Aufwand mit modernen programmatischen Mitteln relativ leicht automatisieren. So benötigt ein beliebtes Lexer-Generator-Tool wie Logos rund 80 Zeilen Code, um dieses Stacking-Prinzip zu implementieren.
Interessanterweise zeigt sich hier auch, wie sehr kreative Problemlösung in der Softwareentwicklung Neues hervorbringen kann. Oft ist es nicht die einzelne Optimierung an sich, sondern der Perspektivwechsel weg von der reinen Bit- und Byte-Einsparung hin zu einer ganzheitlichen Betrachtung der Zusammenhänge aus Speicherlayout, Hardware-Eigenschaften und Compiler-Verhalten, der den entscheidenden Durchbruch bringt. Natürlich ist das Stapeln von Lookup-Tabellen nicht die ultimative Antwort auf alle Performancefragen im Compilerbau. Kontextabhängige Faktoren, wie die spezifische Anwendung, die Zielplattform und die verwendeten Pattern, beeinflussen, wie effektiv der Ansatz wirkt. Dennoch ist diese Methode ein wichtiger Schritt hin zu ressourcenschonender, schneller Codegenerierung mit geringerem Cache-Footprint.
Zusammenfassend lässt sich sagen, dass das Stapeln von Lookup-Tabellen in Lexer-Generatoren ein eleganter und pragmatischer Ansatz ist, Entwicklungskosten zu reduzieren und Laufzeit zu optimieren. Während klassische Match-Expressions und einfache Lookup-Tabellen ihre Daseinsberechtigung behalten, eröffnen kombinierte Bitmasken in gestapelten Tabellen neue Möglichkeiten für die nächste Generation von Scannern und Parsern. Diese Technik zeigt exemplarisch, wie das Zusammenspiel von Softwarearchitektur, Hardware-Know-how und Compiler-Optimierung in der Praxis spürbaren Mehrwert erzeugt. Entwickler, die an leistungsfähigen Lexer-Generatoren arbeiten oder sich mit der Optimierung von Parsing-Prozessen beschäftigen, sollten den Ansatz des Stapelns von Lookup-Tabellen genau betrachten. Er ist ein Werkzeug, das in geeigneten Kontexten deutliche Vorteile bringt und die Performance dank effizienterer Speicher- und Cache-Nutzung steigert.
So wird aus einer ursprünglich simplen Idee eine Innovation, die das Schreiben schneller und schlanker Compiler maßgeblich unterstützt. Abschließend lohnt es sich, stets die Hardware als ebenso wichtigen Faktor bei der Entwicklung von performantem Code zu betrachten. Kleine Optimierungen wie die Umwandlung des Vergleichsbefehls in den Test-Befehl auf Maschinenebene können maßgeblich die Geschwindigkeit beeinflussen, gerade wenn man bedenkt, wie viele Iterationen ein Lexer in realen Anwendungen durchläuft. Stacking Lookup Tables vereinigt solche mikroarchitektonischen Verbesserungen mit speichereffizientem Design und schafft so einen bemerkenswerten technischen Fortschritt im Bereich der Lexer-Generierung.