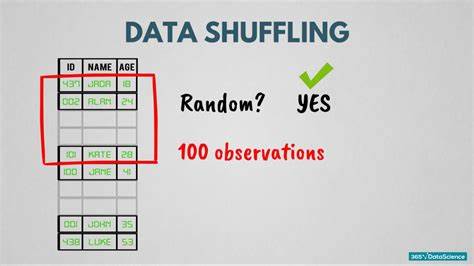
In der heutigen datengetriebenen Welt wächst die Menge an verfügbaren Informationen ständig und erreicht immer häufiger Dimensionen, die den Umgang mit ihnen vor besondere Herausforderungen stellen. Insbesondere das Mischen großer Datensätze, ein grundlegender Schritt in vielen Machine Learning-Workflows, kann schnell zu einem Flaschenhals werden, wenn herkömmliche Methoden an ihre Grenzen stoßen. Ein ungemischter Datensatz führt oft zu fehlerhaften Modellen und ineffizientem Training, weshalb das Thema „Wie mische ich große Datensätze? “ mehr Aufmerksamkeit verdient als je zuvor. Warum ist das Mischen von Daten so entscheidend? Das Mischen eines Datensatzes sorgt dafür, dass Trainingsbeispiele über die verschiedenen Mini-Batches zufällig verteilt sind, was die statistische Unabhängigkeit unterstützt und die Varianz der Gradienten verbessert.
Ohne diese zufällige Verteilung können Modelle an Phänomene wie seriellen Korrelationen leiden, die das Lernen erschweren und zu suboptimalen Konvergenzen führen. Ein klassisches Beispiel verdeutlicht dies: Wenn ein Datensatz zuerst 50. 000 Katzenbilder und danach 50. 000 Hunde enthält, lernt ein Modell ohne Mischen tendenziell erst ausschließlich Katzen zu erkennen und erst danach Hunde – was zu schlechter Generalisierung und langsamerem Lernen führt. Die Limitierungen klassischer Shuffle-Methoden bei sehr großen Datenmengen Im Arbeitsspeicher (RAM) passen kleine bis mittelgroße Datensätze häufig komplett hinein. Hier ist das Fisher–Yates-Verfahren ein bewährter Standard, der eine echte Zufallspermutation in linearer Zeit erzeugt und einfach implementierbar ist. Sobald die Daten die Grenzen des verfügbaren Speichers überschreiten, scheitert dieses Verfahren jedoch, da es sofort den kompletten Datensatz hält und ständig Positionswechsel durchführt.
In der Praxis arbeiten viele Unternehmen und Forschungseinrichtungen mit Daten im Bereich von Milliarden Beispielen, bei denen einzelne Datenelemente bereits mehrere Kilobyte bis Megabyte umfassen können. Das klassische In-Memory-Shuffling wird hier deshalb unpraktikabel oder unmöglich. Der Versuch, direkten Zufallszugriff auf große Datendateien durchzuführen, ist zudem nicht nur technisch aufwendig, sondern auch äußerst ineffizient, da die Zugriffslatenzen bei externem Speicher wie SSDs oder Festplatten deutlich höher sind als bei sequenziellen Zugriffen. Zwei-Pass-Algorithmus: Eine robuste Lösung für Big Data Eine elegante und praktisch erprobte Lösung für das Problem ist der sogenannte Zwei-Pass-Algorithmus. Dabei wird der Datensatz zuerst in mehrere kleinere, handhabbare „Haufen“ (sogenannte piles) aufgeteilt, die einzeln in den Arbeitsspeicher passen und dort effizient gemischt werden können. Anschließend werden die gemischten Segmente sequenziell zusammengefügt.
Zunächst wird eine geeignete Anzahl von Haufen bestimmt, die einerseits groß genug sind, um den Aufwand niedrig zu halten, andererseits aber klein genug, um sie im RAM bearbeiten zu können. Bei der ersten Verarbeitung wird jeder Datenpunkt per Zufall einer dieser Gruppen zugeordnet und in dieser gespeichert. So entstehen M Haufen, deren erwartete Größe sich an der Gesamtzahl der Datenpunkte orientiert. Im zweiten Schritt werden die Dateninhalte jedes Haufens einzeln in den Arbeitsspeicher geladen und dort mit einem klassischen Shuffling-Verfahren, beispielsweise Fisher–Yates, vollständig gemischt. Abschließend werden die einzelnen gemischten Haufen nacheinander zu einer endgültigen, zufällig permutierten Datei zusammengefügt. Die Vorteile dieses Ansatzes liegen auf der Hand: Im Vergleich zum naive Zufallszugriff auf einzelnen Datenpunkte, der extrem ineffizient sein kann, beträgt die Laufzeit des Zwei-Pass-Verfahrens ein Vielfaches weniger.
Das Verfahren nutzt vor allem das wesentlich schnellere sequenzielle Lesen und Schreiben großer Datenblöcke, anstatt teure Sprünge zwischen unterschiedlichen Speicherbereichen durchzuführen. Mathematisch lässt sich die Korrektheit des Verfahrens elegant begründen. Man kann sich vorstellen, jedem Datenpunkt eine Zufallszahl zwischen 0 und 1 zuzuordnen und anschließend entsprechend dieser Zufallszahlen zu sortieren – das entspricht einer vollkommen zufälligen Permutation. Die Zuweisung zu Haufen im ersten Pass entspricht dabei einer Art Radixsort auf den ersten Stellen der Zufallszahlen, und das anschließende Mischen innerhalb der Haufen entspricht einem zweiten Sortierschritt auf den verbleibenden Stellen. Umgang mit ungleichmäßig großen Haufen und Speicherengpässen Natürlich besteht bei rein zufälliger Einteilung die Möglichkeit, dass einzelne Haufen unerwartet groß werden und so nicht mehr vollständig in den Arbeitsspeicher passen.
Die Standardabweichung der Größe eines Haufens liegt ungefähr bei der Quadratwurzel der erwarteten Haufengröße, sodass man durch konservative Kalkulation und ausreichende Puffer die Wahrscheinlichkeit eines solchen Überschreitens stark minimieren kann. Falls doch ein Haufen zu groß für die Bearbeitung im RAM ist, gibt es mehrere pragmatische Lösungswege. Einerseits kann der Algorithmus rekursiv auf diesen zu großen Haufen erneut angewandt werden, wodurch sich die Datenmenge weiter aufteilt. Andererseits ist es oft praktisch und ausreichend, den gesamten Prozess einfach neu zu starten und eine andere zufällige Aufteilung zu generieren. Die geringe Eintrittswahrscheinlichkeit für solche Ereignisse sorgt dafür, dass ein Wiederanfangen im Mittel kaum zusätzliche Laufzeit kostet und die Zufälligkeit der Permutation dadurch nicht beeinflusst wird.
Optimierung durch Parallelisierung und Integration in Preprocessing In vielen realen Fällen liegt der Datensatz nicht in einer einzigen Datei vor, sondern verteilt sich auf mehrere. Auch ist die Datenvorverarbeitung häufig ein notwendiger Schritt vor dem eigentlichen Training oder der Analyse. Beide Praxisbedingungen begünstigen eine nahtlose Kombination der Aufteilung mit der Vorverarbeitung, sodass während der Datenaufbereitung die Beispieldaten direkt an die vorgesehenen Haufen verteilt werden. Dies ist nicht nur elegant, sondern spart durch die Gemeinsamkeit von Lese- und Schreibzugriffen wesentliche Laufzeit ein und reduziert die notwendige Zwischenspeicherung. Die parallele Verarbeitung mehrerer Dateien und gleichzeitige Aufteilung kann auf modernen Multi-Core-Systemen und verteilten Umgebungen effizient skaliert werden.
Darüber hinaus erlaubt der Ansatz, die zweiten Shuffling-Phasen zu einem späteren Zeitpunkt durchzuführen – also die Daten erst ungemischt im Arbeitsspeicher zu halten, sie aber beim Zugriff oder Training einzeln mit dem Fisher–Yates-Algorithmus zu mischen. Das reduziert den Speicherbedarf und gibt die Möglichkeit, die Mischen flexibel an Nutzungsszenarien anzupassen. Praktische Einsatzszenarien Der beschriebene Ansatz lässt sich in vielen Bereichen gewinnbringend einsetzen. Unabhängig davon, ob es sich um Bilder, Textdaten, Zeitreihendaten oder andere Datentypen handelt, profitieren große ML-Projekte von vollständig oder zumindest ausreichend gemischten Daten. Im Finanzbereich, wie bei Jane Street, sind Datensätze oft sehr groß und weisen eine niedrige Signal-Rausch-Relation auf, was das ordnungsgemäße Mischen als naturgegebenes Muss unterstreicht.
Auch in der medizinischen Forschung oder bei autonomen Fahrzeugen, wo die Menge an Sensor- und Beobachtungsdaten enorm ist, stellt diese Methode eine Basis für effektivere Trainingsprozesse dar. Shuffling als Teil der Datenpipeline Der Einsatz des Zwei-Pass-Algorithmus sollte nicht isoliert betrachtet werden, sondern als integraler Bestandteil einer modernen Datenpipeline, die neben dem Shuffling auch Vorverarbeitung, Augmentation, Filterung und weitere Transformationen umfasst. Die Möglichkeit, bereits während der Vorverarbeitung Daten aufzuteilen, verringert die Wartezeiten und erhöht die Effizienz. Des Weiteren kann diese Aufteilung als Grundlage für smarte Mini-Batch-Erzeugung dienen, um durch erneutes Mischen innerhalb kleinerer Datenblöcke die Trainingseffizienz weiter zu verbessern. Für kontinuierlich eingehende Datenströme ist es sogar möglich, mit Puffern in Form von zirkulären Datenpools zu arbeiten, die eine Art laufend aktualisierte Teilmischung des Datensatzes darstellen.
Performance-Vergleich und Bedeutung der Speicherarchitektur Aus Messungen geht hervor, dass der sequenzielle Zugriff, wie er vom Zwei-Pass-Verfahren genutzt wird, auf schnellen SSDs und gut optimierten Speichersystemen bis zu 1000-mal schneller sein kann als der zufällige Zugriff auf einzelne Datenelemente. Der Grund liegt in der Latenz und Bandbreite der Speichermedien sowie in der Art und Weise, wie Daten organisiert und komprimiert sind. Selbst bei großen, komprimierten Datenmengen verhindert das algorithmische Design unnötige Verteilungs- und Zugriffsoperationen, die häufig Effizienz und Geschwindigkeit erheblich beeinträchtigen. Unterschiedliche Hardwareausstattungen können diese Zahlen variieren lassen, doch der Grundsatz bleibt: das Minimieren zufälliger Zugriffe zahlt sich aus. Fazit Das Mischen großer Datensätze ist eine essentielle Fähigkeit in modernen datenintensiven Anwendungen.
Die klassische In-Memory-Methode stößt bei großen Datenmengen schnell an ihre Grenzen und kann nicht mit der Geschwindigkeit und Zuverlässigkeit konkurrieren, die Big Data Projekte benötigen. Der Zwei-Pass-Algorithmus bietet eine einfache, saubere und vor allem praxisbewährte Lösung: Durch das intelligente Aufteilen in kleine Haufen und die Nutzung effizienter sequentieller Zugriffe wird das Shuffling auch für Milliarden von Datenpunkten handhabbar. Praktische Tipps wie Pufferzugaben, parallele Verarbeitung und Integration in die Datenvorbereitung machen den Prozess noch robuster und anwendungsfreundlicher. Wer also mit großen Daten hantiert und hochwertige, zufällig permutierte Trainingssets erzeugen möchte, kommt an diesem Ansatz kaum vorbei. Dabei lässt sich das Verfahren flexibel an unterschiedliche Nutzungsszenarien anpassen – von vollständigen Shuffles bis hin zu „halben“ Shuffles mit sich ständig aktualisierten Datenfenstern.
Durch den gezielten Einsatz dieser Techniken kann man die Effizienz von Machine Learning-Workflows substantiell steigern und letztlich bessere Modelle in kürzerer Zeit trainieren – eine echte Win-Win-Situation für Unternehmen und Forschung gleichermaßen.