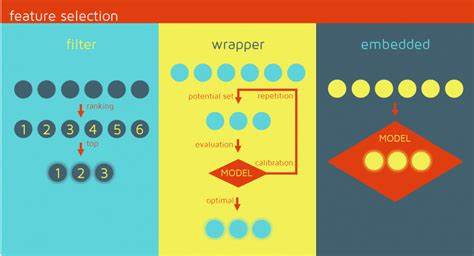
Im Bereich des maschinellen Lernens gewinnt die effiziente Nutzung von Daten immer mehr an Bedeutung. Dabei treffen zwei Ansätze aufeinander, die auf den ersten Blick ähnliche Ziele verfolgen, sich jedoch grundlegend unterscheiden: Active Learning und Data Filtering. Beide Methoden beschäftigen sich mit der Frage, welche Daten für das Training eines Modells eingesetzt werden sollten, doch sie gehen dabei unterschiedliche Wege. Während Active Learning gezielt die informativsten Datenpunkte auswählt, filtert Data Filtering von vornherein weniger relevante Daten aus. Diese scheinbar kleine Unterscheidung entpuppt sich als essenziell für die Trainingsmethodik und die spätere Leistungsfähigkeit von Modellen. Der zentrale Unterschied zwischen Active Learning und Data Filtering liegt in dem Zeitpunkt und der Vorgehensweise der Datenselektion. Active Learning erfolgt dynamisch und iterativ während des Trainingsprozesses.
Hier werden zu jedem Zeitpunkt jene Proben identifiziert und ausgewählt, die für den aktuellen Zustand des Modells den größten Informationsgewinn versprechen. Im Gegensatz dazu trifft Data Filtering eine frühzeitige Entscheidung, indem es vor dem Beginn des Trainings Datenpunkte entfernt, die als wenig informativ gelten. Diese Vorfilterung soll das Training effizienter gestalten, indem unnötiger Rechenaufwand vermieden wird. Das zugrundeliegende Konzept der Informationsbewertung ist dabei ein weiterer entscheidender Faktor. Beide Methoden verwenden sogenannte Informativeness Scores, um die Relevanz einzelner Datenproben einzuschätzen. Während Active Learning aktiv die Proben mit den höchsten Scores auswählt, lehnt Data Filtering jene mit den niedrigsten ab. Dieses Prinzip könnte auf den ersten Blick als mathematisch analog gesehen werden, da die Auswahl der besten zehn Prozent dem Ausschluss der schlechtesten neunzig Prozent entspricht.
In der Praxis jedoch beeinflussen der Zeitpunkt der Entscheidung und die Art der Umsetzung die Ergebnisse stark. Ein zentraler theoretischer Rahmen, der die unterschiedlichen Wirkungsweisen von Active Learning und Data Filtering erklärt, ist die Eigenschaft der Submodularität. Diese bezeichnet ein Phänomen, bei dem der zusätzliche Informationswert eines weiteren Datenpunkts mit zunehmender Menge bereits ausgewählter Daten abnimmt. Anders ausgedrückt: Je mehr Informationen ein Modell bereits erhalten hat, desto geringer ist der Nutzen zusätzlicher, ähnlicher Daten. Dadurch entstehen abnehmende Erträge, die sowohl in der Theorie als auch in zahlreichen praktischen Anwendungen beobachtet werden. Für Active Learning bedeutet Submodularität, dass die Relevanz einzelner Datenpunkte sich während des Trainings verändert. Anfangs kann ein Datenpunkt besonders informativ erscheinen, verliert jedoch an Bedeutung, sobald ähnliche Informationen bereits aufgenommen wurden.
Deshalb ist eine ständige Neubewertung der Informativeness Scores für Active Learning essenziell. Durch diese iterative Bewertung kann das Modell stets die für seinen Lernfortschritt optimalen Proben auswählen. Im Gegensatz dazu baut Data Filtering auf der Annahme auf, dass die Informativeness Scores zu Trainingsbeginn stabil genug sind, um eine frühe Ablehnung wenig informativer Daten sicher durchzuführen. Die Submodularität liefert dafür theoretischen Rückhalt, indem sie nahelegt, dass Proben mit geringem Informationswert anfangs auch im weiteren Verlauf uninteressant bleiben. Dadurch kann Data Filtering den Trainingsprozess beschleunigen, ohne die Modellqualität wesentlich zu beeinträchtigen. Die praktische Umsetzung von Active Learning erfordert ein engmaschiges Monitoring der Dateninformativeness während des Trainings.
Methoden wie BALD (Bayesian Active Learning by Disagreement) nutzen hierzu informationstheoretische Größen wie die erwartete Informationszunahme, um die Auswahl von Trainingsdaten zu steuern. Dadurch reagiert der Lernprozess flexibel auf die aktuellen Modellkenntnisse und kann besonders komplexe oder bislang wenig gelernte Bereiche des Datenraums stärken. Data Filtering gestaltet sich etwas einfacher, da hier die Auswahl vor dem Training erfolgt. Basierend auf anfänglichen Einschätzungen der Informativeness werden Datenpunkte aus dem Trainingspool ausgeschlossen. Dies spart Rechenressourcen und Trainingszeit, birgt jedoch das Risiko, wichtige Informationen vorzeitig zu verwerfen, wenn sich die Bedeutung von Daten im Verlauf des Trainings ändert. Die Theorie der Submodularität mildert dieses Risiko ab, ist jedoch keine absolute Garantie. Ein weiterer interessanter Gesichtspunkt ergibt sich aus einer bayesianischen Perspektive.
In dieser Sichtweise können sowohl Active Learning als auch Data Filtering als Methoden interpretiert werden, die darauf abzielen, die Unsicherheit in der Modellvorhersage effektiv zu verringern. Active Learning wählt gezielt Datenpunkte aus, die den erwarteten Posterior des Modells am stärksten verändern, also maximal informativ sind. Data Filtering entfernt hingegen solche, die kaum zur Verringerung dieser Unsicherheit beitragen. So entsteht ein gemeinsames Fundament für beide Ansätze, das sie als unterschiedliche Strategien zur Informationsoptimierung im Lernprozess beschreibt. Ein praktisches Beispiel für die Umsetzung von Active Learning liefert das beliebte MNIST-Datenset zur Handschrifterkennung. Dabei kann ein klassisches Modell wie LeNet-5 mit Monte Carlo Dropout genutzt werden, um iterativ Datenstücke zu wählen, deren informatorischer Gehalt anhand von BALD-Scores gemessen wird.
Im Verlauf des Trainings zeigen sich typische Muster: Die Informativeness einzelner Datenpunkte fällt nach deren Verwendung ab, und die Reihenfolge der ausgewählten Daten verändert sich dynamisch. Solche Experimente unterstreichen die Notwendigkeit, die Wertigkeit von Daten während des gesamten Trainings kontinuierlich neu zu bewerten. Trotz der theoretischen Eleganz von Submodularität und der klaren Trennung zwischen Auswahl und Ablehnung ist die Realität oft komplexer. Approximationen bei der Berechnung von Informativeness Scores, Modellunsicherheiten und zufällige Effekte im Trainingsprozess können dazu führen, dass informative Datenpunkte erst spät an Bedeutung gewinnen oder uninformative Punkte unerwartet relevant werden. Dies stellt insbesondere Data Filtering vor Herausforderungen, da hier eine robuste Einschätzung auf Grundlage weniger Vorinformationen erfolgen muss. Vor diesem Hintergrund gewinnen hybride Konzepte an Relevanz, die die Vorteile beider Methoden verbinden.
So könnten initiale Filterungen durch Data Filtering erfolgen, um die Datenmenge zu reduzieren, gefolgt von iterativen Active Learning Strategien, die während des Trainings gezielt die wirklich relevanten und noch ungenutzten Daten auswählen. Dies ermöglicht eine Balance zwischen Effizienz und Flexibilität und stärkt die Modellperformance, ohne unnötige Rechenressourcen zu verschwenden. Zusammenfassend lässt sich sagen, dass das Zusammenspiel von Active Learning und Data Filtering einen zentralen Beitrag zur datenbewussten Optimierung von maschinellen Lernprozessen leistet. Der wesentliche Unterschied zwischen Auswahl und Ablehnung manifestiert sich nicht nur in der zeitlichen Einordnung der Datenselektion, sondern auch in der praktischen Nutzung von Informationswerten und den zugrundeliegenden mathematischen Eigenschaften wie der Submodularität.
Das Verständnis dieser Zusammenhänge eröffnet Entwicklern und Forschern Möglichkeiten, Trainingsverfahren gezielt zu steuern und Datenressourcen optimal zu nutzen. Gleichzeitig bleibt die Erforschung von Ausnahmen und Grenzfällen, bei denen die theoretischen Annahmen der Submodularität nicht greifen, ein spannendes Forschungsfeld mit großem Potenzial für innovative Ansätze im Bereich des maschinellen Lernens. Die Weiterentwicklung von Methoden, die flexibel auf Änderungen in der Dateninformativeness reagieren und die Grenzen vorhandener Theorien überwinden, ist entscheidend, um Lernsysteme noch leistungsfähiger und effizienter zu gestalten. So kann die Kombination von Auswahl- und Ablehnungsstrategien künftig in vielfältigen Anwendungen zu verbesserter Genauigkeit, kürzeren Trainingszeiten und ressourcenschonendem Arbeiten führen.