Virtuelle Realität

Ein umfassendes theoretisches Paradigma zum Verstehen des Lernens aus menschlichen Präferenzen

Ein tiefgehender Einblick in die theoretischen Grundlagen des Lernens aus menschlichen Präferenzen, der aktuelle Herausforderungen adressiert und neue Ansätze wie das \PsiPO-Framework erläutert, um die Effizienz und Zuverlässigkeit von Modellen zu verbessern.

Ein umfassendes theoretisches Paradigma zum Verstehen des Lernens aus menschlichen Präferenzen

Das Lernen aus menschlichen Präferenzen hat in den letzten Jahren enorm an Bedeutung gewonnen, vor allem im Bereich der künstlichen Intelligenz. Immer mehr Anwendungen, von interaktiven Systemen bis hin zu personalisierten Empfehlungen, verlangen eine präzise Modellierung und Interpretation menschlicher Vorlieben. Doch trotz der praktischen Erfolge stehen Forscher vor fundamentalen theoretischen Fragen, die das Verständnis und die Verbesserung dieser Verfahren erschweren. Der verbreitete Einsatz von Reinforcement Learning with Human Feedback (RLHF), also Verstärkendes Lernen mit menschlichem Feedback, stützt sich auf zwei wesentliche Annahmen, die in der Praxis oft getroffen werden. Erstens wird angenommen, dass sich paarweise Präferenzen - also die Auswahl einer bevorzugten Option gegenüber einer anderen - durch punktuelle Bewertungen, also einzelnen Belohnungen, ersetzen lassen.

Zweitens geht man davon aus, dass das Belohnungsmodell, das auf diesen punktuellen Rückmeldungen basiert, gut genug generalisiert und somit auch Verhalten außerhalb der ursprünglich gesammelten Daten verlässlich vorhersagen kann. Diese beiden Vereinfachungen erleichtern die Modellierung und ermöglichen die Funktionalität vieler Systeme, führen jedoch auch zu potenziellen Fehlerquellen. Wenn die Annahme nicht stimmt, dass paarweise Präferenzen durch punktuelle Belohnungen akkurat beschrieben werden können, kann das Modell inkorrekte Motivationselemente lernen. Ebenso ist die Generalisierung auf aus der Verteilung fallende Daten riskant, wenn das Belohnungsmodell nicht robust genug ist. Der jüngst vorgeschlagene Ansatz des Direct Preference Optimisation (DPO) versucht, der zweiten Annahme zu entgehen, indem er direkt eine Politik aus gesammelten Daten lernt, ohne dafür ein separates Belohnungsmodell zu verwenden.

Dieses Verfahren behebt also die Notwendigkeit, ein Belohnungsmodell zu trainieren, konzentriert sich aber weiterhin auf die erste Vereinfachung – nämlich die Ersatzannahme von paarweisen Präferenzen durch punktuelle Belohnungen. Um diese beiden zentralen Limitationen zu adressieren, setzen sich die Forscher mit einem neuen allgemeinen theoretischen Paradigma auseinander, welches unter der Bezeichnung \PsiPO firmiert. Dabei steht \PsiPO für ein generisches Optimierungsziel, das direkt mit paarweisen Präferenzen arbeitet und keine der beiden traditionellen Annahmen benötigt. Das bedeutet, dass dieses Paradigma einerseits die tatsächlichen Vergleichsdaten nutzt und andererseits ohne äußeres Belohnungsmodell auskommt. Dieser neue Ansatz ermöglicht es, bisherige Verfahren wie RLHF und DPO als Spezialfälle innerhalb eines übergeordneten Rahmens zu verstehen. Durch diese theoretische Einbettung werden Rückschlüsse über deren Eigenschaften, Stärken und Schwächen möglich.

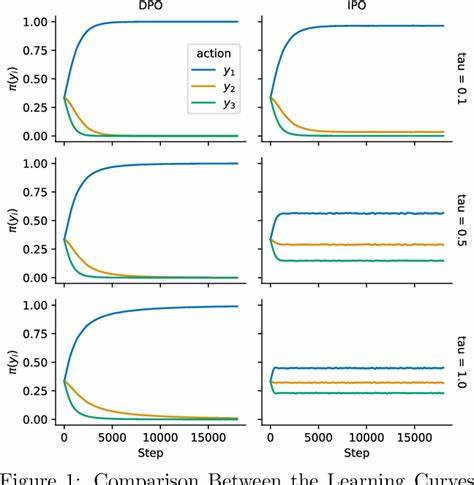
So zeigen die Autoren auf, wo und wie etwa RLHF aufgrund der zugrundeliegenden Approximationen versagen oder suboptimale Entscheidungen treffen kann. Ebenso lassen sich die Grenzen von DPO unter dem Blickwinkel des \PsiPO-Frameworks genauer analysieren. Ein besonders interessanter Spezialfall entsteht, wenn \Psi als Identitätsfunktion gewählt wird. Hier können die Forscher eine effiziente Optimierungsstrategie entwickeln und zugleich strenge Leistungsgarantien beweisen. In empirischen Tests auf erklärenden Beispielen zeigen sie zudem, dass dieses Verfahren dem DPO in seiner Effektivität überlegen sein kann. Solche Ergebnisse unterstreichen den praktischen Mehrwert dieses theoretischen Paradigmas, da es nicht nur das Verständnis schärft, sondern auch direkt verbesserte Lernalgorithmen ermöglicht. Die Bedeutung dieser Arbeit liegt somit nicht nur in der theoretischen Neuinterpretation des Lernens aus menschlichen Präferenzen, sondern auch in der praktischen Anwendung.

Es wird ein Weg aufgezeigt, der es erlaubt, die Herausforderungen der aktuellen Methoden zu überwinden, um robustere und aussagekräftigere Modelle zu entwickeln. Gerade angesichts der zunehmenden Komplexität und Ambiguität menschlicher Rückmeldungen sind solche Fortschritte essenziell. Zudem kann das Verständnis und die Anwendung von \PsiPO dazu beitragen, ethische und methodische Probleme zu minimieren. Indem das Lernen direkt aus den tatsächlichen Präferenzpaaren geschieht ohne Zwischenschritt über ein Belohnungsmodell, wird potenziell auch die Verzerrung reduziert, die durch falsche Annahmen oder fehlerhafte Generalisierung entsteht. Dies ist besonders relevant in sensiblen Kontexten wie der Moderation von Inhalten oder in Systemen, die Entscheidungen mit direktem Einfluss auf Menschen treffen. Abschließend lässt sich sagen, dass das vorgestellte Paradigma \PsiPO den Status quo im Bereich des Lernens aus menschlichen Präferenzen erheblich erweitert.

Es schafft eine solide theoretische Basis, die existierende Ansätze integriert und zugleich neue Strategien ermöglicht. Forschende und Entwickler bieten sich dadurch neue Werkzeuge an, um perfektionierte Modelle zu erschaffen, die sowohl auf theoretischer Ebene fundiert als auch in der Praxis wirkungsvoll sind. Die Weiterentwicklung und Anwendung solcher Paradigmen wird in den kommenden Jahren vermutlich eine zentrale Rolle spielen, um die Schnittstelle zwischen menschlicher Intuition und künstlicher Intelligenz noch effizienter und nachvollziehbarer zu gestalten. Der Zwischenschritt eines Belohnungsmodells könnte künftig überflüssig werden, was neue Horizonte für personalisierte, faire und nachvollziehbare KI-Systeme eröffnet. Insgesamt handelt es sich um einen Meilenstein in der Erforschung von Lernmethoden aus menschlichen Präferenzen, der sowohl theoretisch als auch praktisch wegweisend ist.
OKX Partnerinhalte

Registrieren Sie sich bei OKX und erhalten Sie Ihren Willkommensbonus

OKX ist eine Plattform für Spot- und Futures-Handel, P2P-Tausch und Krypto-Sparpläne. Ein neues Konto über diesen Link eröffnet Zugang zum Willkommensbonus-Programm: bis zu 10.000 USDT für Ihre ersten Schritte an der Börse.

Konto erstellen und Bonus erhalten →

18+ · Partnerlink. Kryptowährungen sind volatil: Sie können Ihre Einlage verlieren.

Als Nächstes
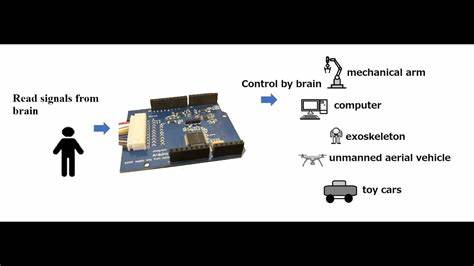
EEG-Messung mit Arduino: Eigenes Gehirnsignal einfach erfassen und analysieren
Samstag, 14. November 2026. EEG-Messung mit Arduino: Eigenes Gehirnsignal einfach erfassen und analysieren

Das menschliche Gehirn ist eine der faszinierendsten und komplexesten Schaltzentralen unseres Körpers. Seine Aktivität äußert sich durch elektrische Signale, die als EEG (Elektroenzephalographie) bezeichnet werden.

Erfolgsstrategien aus der Finanzkrise: Wie ein Deep-Tech-Unicorn aus einem Förderkollaps entstand
Samstag, 14. November 2026. Erfolgsstrategien aus der Finanzkrise: Wie ein Deep-Tech-Unicorn aus einem Förderkollaps entstand

Die Welt technologischer Innovationen steht oft vor unvorhersehbaren Herausforderungen. Besonders in der Deep-Tech-Branche, in der Visionen von bahnbrechenden Technologien wie der Kernfusion weitergetragen werden, können plötzliche finanzielle Rückschläge katastrophale Auswirkungen haben.

Warum Toll Brothers (TOL) eine lohnenswerte Investition ist
Samstag, 14. November 2026. Warum Toll Brothers (TOL) eine lohnenswerte Investition ist

Toll Brothers, Inc. ist in der amerikanischen Bauindustrie ein bekannter Name, der sich seit vielen Jahren auf den Bau von hochwertigen und luxuriösen Einfamilienhäusern spezialisiert hat.

Einzelhändler fordern EU-Kommission zum Handeln gegen Visa und Mastercard auf
Samstag, 14. November 2026. Einzelhändler fordern EU-Kommission zum Handeln gegen Visa und Mastercard auf

Die Debatte um die dominierende Stellung der US-amerikanischen Zahlungsnetzwerke Visa und Mastercard gewinnt in Europa zunehmend an Bedeutung. Europas größte Einzelhändler und Online-Händler haben die Europäische Kommission darauf gedrängt, gegen die hohen und intransparenten Gebühren der beiden Marktführer vorzugehen.

Designyff – Mit kostenlosen Copy-Paste UI-Snippets schneller entwickeln
Samstag, 14. November 2026. Designyff – Mit kostenlosen Copy-Paste UI-Snippets schneller entwickeln

In der heutigen digitalen Welt, in der die Geschwindigkeit der Entwicklung und die Qualität der Benutzeroberfläche entscheidend sind, suchen Softwareentwickler und Designer ständig nach Wegen, um ihre Produktivität zu steigern und gleichzeitig ästhetisch ansprechende, funktionale Interfaces zu schaffen. Designyff setzt genau hier an und bietet eine innovative Lösung für all jene, die im Bereich UI/UX tätig sind.

EconomyGuesser: Das Wirtschaftsrätsel, das Wordle-Fans begeistert
Samstag, 14. November 2026. EconomyGuesser: Das Wirtschaftsrätsel, das Wordle-Fans begeistert

Die Welt der Online-Rätselspiele hat in den letzten Jahren einen enormen Aufschwung erlebt. Vor allem durch den Erfolg von Wordle wurde das Konzept, ein simples, wiederholbares Spiel mit täglicher Herausforderung anzubieten, zur Inspiration für zahlreiche Nachahmer und kreative Spin-offs.

Märkte im Gleichgewicht: Hoffnung auf neue Handelsabkommen belebt die Finanzwelt
Samstag, 14. November 2026. Märkte im Gleichgewicht: Hoffnung auf neue Handelsabkommen belebt die Finanzwelt

In den letzten Wochen haben die globalen Finanzmärkte eine bemerkenswerte Erholung erfahren. Nachdem der im April 2025 verkündete Zollkonflikt zwischen den USA und anderen großen Wirtschaftsnationen für erhebliche Verunsicherung sorgte, haben viele Märkte mittlerweile ihre Verluste ausgeglichen oder sogar leichte Gewinne verbucht.

Weitere Artikel zum Thema
500.000 Dollar Altersvorsorge: So viel können Sie jährlich sicher ausgeben
Samstag, 14. November 2026. 500.000 Dollar Altersvorsorge: So viel können Sie jährlich sicher ausgeben

Viele Menschen träumen davon, mit ausreichenden Ersparnissen entspannt ihren Ruhestand zu genießen. Ein gängiger Richtwert für ein solides finanzielles Polster im Alter liegt zwischen 500.

Die ungewöhnliche Mathematik hinter der Form von Rosenblättern
Samstag, 14. November 2026. Die ungewöhnliche Mathematik hinter der Form von Rosenblättern

Rosen sind seit Jahrhunderten ein Symbol für Schönheit, Liebe und Naturwunder. Ihre zarten Blütenblätter, die sich elegant nach außen rollen und an den Spitzen spitz zulaufen, ziehen seit jeher die Aufmerksamkeit von Botanikern, Künstlern und Wissenschaftlern gleichermaßen auf sich.

Visa Revolutioniert den Zahlungsverkehr: Einführung einer Plattform für tokenisierte Fiat-Assets
Freitag, 13. November 2026. Visa Revolutioniert den Zahlungsverkehr: Einführung einer Plattform für tokenisierte Fiat-Assets

Visa präsentiert Plattform für tokenisierte Vermögenswerte: Ein neuer Schritt in die Zukunft der Fiat-unterstützten Tokens Die Welt der Finanztechnologie verändert sich rasant, und Unternehmen, die sich auf innovative Lösungen konzentrieren, nehmen eine führende Rolle in diesem Wandel ein. Visa, ein Gigant im Zahlungsverkehr, hat kürzlich die Einführung einer neuen Plattform für tokenisierte Vermögenswerte angekündigt, die speziell für Fiat-unterstützte Tokens entwickelt wurde.

Telegram und die TON-Blockchain: Expansionspläne in den USA und die Rolle von Trump im Kryptomarkt
Freitag, 13. November 2026. Telegram und die TON-Blockchain: Expansionspläne in den USA und die Rolle von Trump im Kryptomarkt

Die Welt der Kryptowährungen und Blockchain-Technologien entwickelt sich rasant weiter. Eine der neuesten Entwicklungen betrifft die TON-Blockchain, die mit der beliebten Messaging-App Telegram verbunden ist.