Samstag, 14. November 2026.
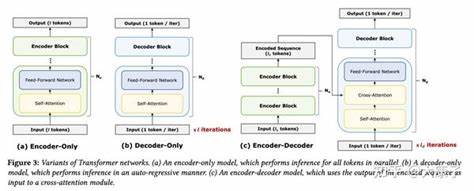
Die Nutzung großer Sprachmodelle (Large Language Models, LLMs) für Anwendungen wie Chatbots, Textgenerierung oder automatisierte Übersetzungen erfordert erhebliche Rechenleistung, vor allem wenn es um die Inferenz geht – also die eigentliche Anwendung des trainierten Modells auf neue Eingabedaten. Gerade die benötigten GPU-Ressourcen sind oft teuer und schwer effizient zu managen, insbesondere wenn man mehrere Cloud-Anbieter und deren verschiedenen Preismodelle sowie Regionen berücksichtigt.