Samstag, 14. November 2026.
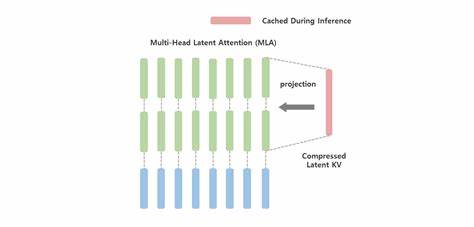
Mit dem Aufstieg großer Sprachmodelle (Large Language Models, LLMs) wächst auch die Herausforderung, immer effizientere Speichertechniken zu entwickeln, um den starken Bedarf an Videospeicher (VRAM) während der Inferenz zu bewältigen. Besonders bei langen Kontextlängen führen die Key-Value-Caches (K/V-Cache) dazu, dass die Speicheranforderungen exponentiell ansteigen.